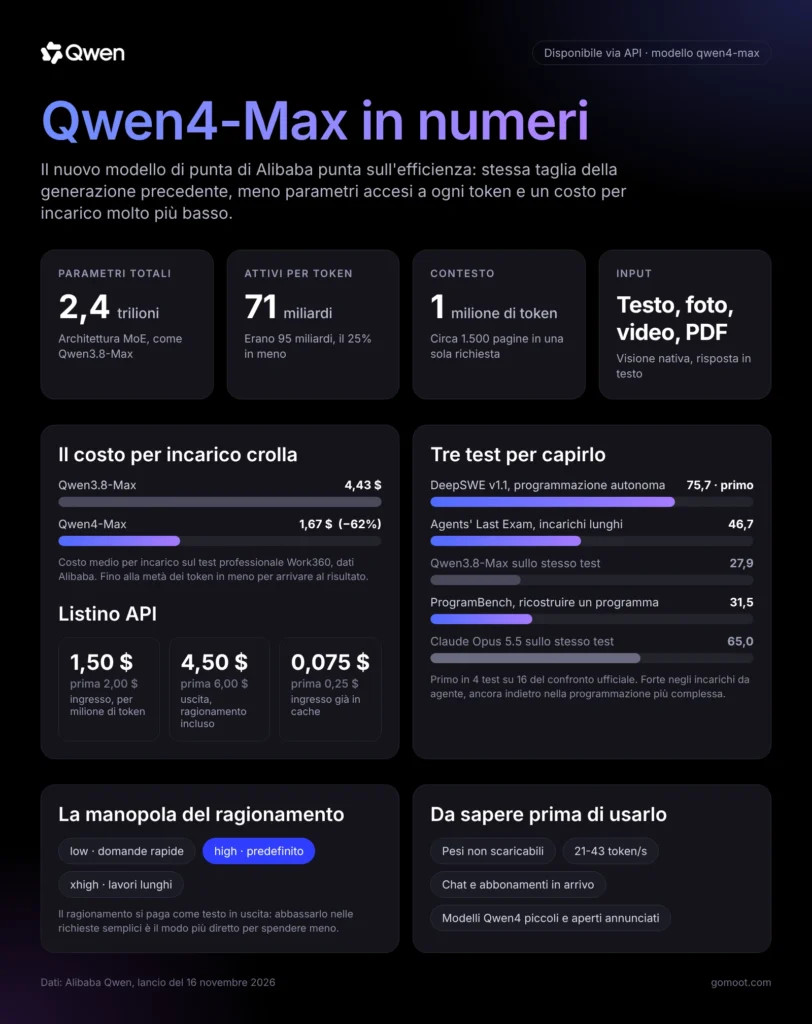
Alibaba ha reso disponibile Qwen4-Max, il primo esponente della famiglia Qwen4. Per il momento si usa solo via API, ma a breve arriverà anche nella chat di Qwen e nei piani in abbonamento. Sulla carta la taglia resta quella di Qwen3.8-Max, perché lo scheletro conta sempre 2,4 trilioni di parametri. Cambia invece il modo in cui la rete li sfrutta, con meno componenti attive per ogni parola generata, una finestra di contesto da un milione di token e la visione nativa per immagini, video e PDF. Il listino scende a 1,50 dollari per milione di token in ingresso e 4,50 in uscita, circa un quarto in meno della generazione precedente, e Qwen4-Max arriva alla risposta producendo meno testo intermedio e quindi meno token. Di conseguenza il costo medio di un lavoro complesso cala molto.
Alibaba lo descrive come un collega digitale capace di portare avanti incarichi lunghi, dal progetto 3D in Blender al fascicolo legale, e qui sta l’aspetto più interessante: il sistema non prova a battere tutti su ogni test, ma rende più economico l’uso degli agenti che lavorano per ore. Diversa è anche la filosofia di distribuzione, perché con Qwen4-Max Alibaba rinuncia ai pesi scaricabili per il suo modello di punta e si allinea a OpenAI e Anthropic, che tengono chiusi i propri modelli di frontiera. Restano infine alcuni limiti pratici, a partire da una velocità di scrittura (token/sec) non brillante.
Stessa stazza di prima, ma con meno token
Per capire cosa cambia bisogna partire da come è fatto un modello MoE (Mixture of Experts). Invece di attivare tutta la rete per ogni token, un sistema di questo tipo la divide in tanti blocchi specializzati e ne accende solo una parte, scelta di volta in volta. Qwen4-Max ha in totale 2,4 trilioni di parametri, ma a ogni passaggio ne usa 71 miliardi, contro i circa 95 del predecessore. Funziona un po’ come un’officina con cento meccanici in cui per ogni intervento ne chiami solo tre: la competenza complessiva resta, la spesa per singola riparazione scende.
Accanto a questo c’è un componente, l’N-gram Embedding da 328 miliardi di parametri. In parole semplici si tratta di una grande tabella di consultazione che memorizza sequenze di termini ricorrenti e le passa alla rete già pronte, così la conoscenza disponibile cresce senza appesantire i calcoli. Alibaba aveva sperimentato l’idea in estate su un sistema più piccolo e ora la porta sul suo modello di punta.
L’altra novità riguarda i testi lunghi. Qwen4-Max alterna livelli Gated DeltaNet, che riassumono la storia della conversazione in uno spazio di memoria a dimensione fissa, a strati di Qwen Sparse Attention, che ripescano solo i frammenti di contesto utili invece di rileggere tutto da capo. Nella pratica un milione di token, cioè circa 1.500 pagine, diventa gestibile senza che il costo di ogni risposta esploda come succedeva usando i modelli di qualche tempo fa.
Completano il quadro i residui con porte (Gated Residual), quattro canali paralleli che regolano il passaggio delle informazioni fra gli strati. Secondo Alibaba hanno reso l’addestramento stabile, senza i picchi di errore che a queste dimensioni costringono spesso a ripartire da un salvataggio precedente. Da tutto ciò deriva l’efficienza dichiarata: Qwen4-Max usa fino alla metà dei token per ottenere risultati migliori di Qwen3.8-Max. Trovo che sia la parte più convincente del progetto, perché incide su tempi e costi di chi lo usa ogni giorno, non solo sulle classifiche.
Dalla chat ai programmi professionali
Alibaba insiste su un’idea precisa, cioè che Qwen4-Max non si limiti a scrivere testo in una chat. Collegato a un agente, cioè a un programma che gli permette di eseguire comandi (per esempio OpenCode) e usare strumenti esterni, il modello sa lavorare direttamente nei software professionali.
In Blender il modello costruisce la geometria, assembla la scena, imposta materiali e luci e lancia il rendering. Con Unity, Unreal Engine e Godot parte da una descrizione in linguaggio naturale e consegna un gioco funzionante, che avvia, osserva e corregge, sistemando l’inquadratura, le animazioni o il ritmo degli scontri. Va detto, tuttavia, che su questo fronte Alibaba insegue più che anticipare. I modelli di frontiera come Claude Opus 5.5, Claude Fable 5.2 e GPT-6 Astra di OpenAI permettono già da tempo di creare giochi e applicazioni lavorando direttamente dentro Blender e altri programmi, grazie a MCP (Model Context Protocol), lo standard che collega un modello di intelligenza artificiale ai software esterni come se fossero suoi strumenti. A questo punto le capacità di base si equivalgono, e la partita si sposta su due domande più pratiche: quale modello porta a termine questi lavori con meno errori e meno correzioni, e quale offre il miglior rapporto fra qualità del risultato e costo per arrivarci.
Qwen ha rilasciato altri casi di utilizzo. In una linea di produzione automobilistica la programmazione della lavorazione di un singolo pezzo meccanico è scesa da circa 475 minuti a 24. Nel lavoro d’ufficio, in un caso di verifica legale prima di una quotazione in borsa, ha ricevuto 198 documenti con nomi e formati disordinati, li ha suddivisi in 14 cartelle e ha prodotto un rapporto di 86 pagine in cui ogni conclusione rimanda al documento d’origine. Nelle analisi finanziarie, il modello consegna un file Excel con celle collegate alla fonte del dato e una presentazione PowerPoint i cui grafici corrispondono uno a uno al foglio di calcolo.
Classifiche da leggere con attenzione
Alibaba ha pubblicato sedici test di confronto, e Qwen4-Max risulta primo in quattro. Tre prove in particolare spiegano bene i suoi punti forti e i suoi limiti. La prima è DeepSWE v1.1, che sottopone il modello a problemi di programmazione da risolvere in autonomia, leggendo il codice, modificandolo e verificando che funzioni. Qwen4-Max ottiene 75,7, cioè risolve circa tre compiti su quattro, il valore più alto del grafico. La seconda è Agents’ Last Exam, dedicata ai lavori lunghi e composti da molte fasi, quelli in cui un agente deve pianificare, usare strumenti e non perdersi per strada. Qui il salto è netto, da 27,9 a 46,7: il predecessore portava a termine circa un incarico su quattro, il nuovo modello si avvicina a uno su due.
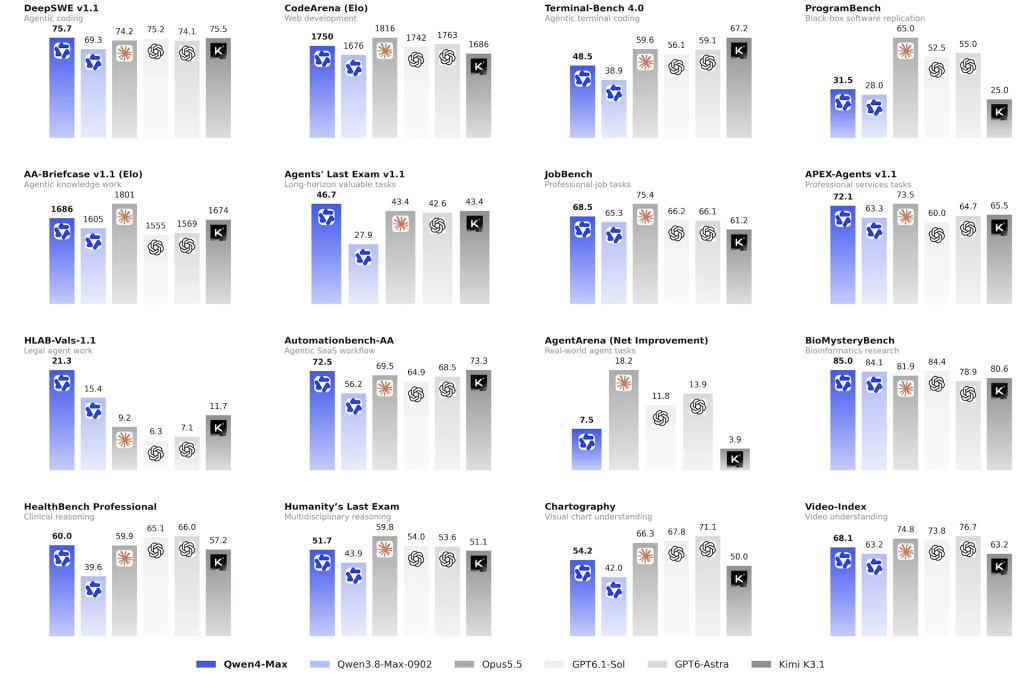
La terza prova mostra invece il rovescio della medaglia. ProgramBench chiede di ricostruire un programma osservandone solo il comportamento dall’esterno, senza vederne il codice. Qwen4-Max si ferma a 31,5, mentre Claude Opus 5.5 arriva a 65. In altre parole riesce in circa un tentativo su tre, contro i due su tre del rivale più forte.
Nei primi test indipendenti di Artificial Analysis Intelligence Index il modello sale a 43 dai 34 della generazione precedente, un risultato sopra la media ma lontano dai 55-65 punti dei modelli occidentali di vertice.
Il prezzo per incarico conta più del listino
Queste sono le tariffe, in dollari per milione di token.
| Voce | Qwen4-Max | Qwen3.8-Max |
|---|---|---|
| Ingresso | 1,50 | 2,00 |
| Uscita (ragionamento compreso) | 4,50 | 6,00 |
| Ingresso già memorizzato | 0,075 | circa 0,25 |
La riduzione più forte riguarda la cache implicita, cioè lo sconto applicato quando invii più volte lo stesso testo, per esempio un lungo documento su cui fai molte domande. Inoltre la tariffa resta unica fino a un milione di token di contesto, mentre alcuni concorrenti applicano sovrapprezzi oltre una certa soglia. Il costo unitario dipende da quanti token servono per finire un lavoro, e qui entra in gioco il ragionamento, cioè il testo che il modello produce fra sé e sé prima di rispondere. In Qwen4-Max è attivo per impostazione predefinita al livello high, viene fatturato come uscita e può arrivare a 131.072 token per singola risposta. Secondo Alibaba, il costo medio per incarico scende da 4,43 a 1,67 dollari, il 62% in meno.
Chi preferisce una spesa fissa potrà usare il Token Plan, un abbonamento a crediti che, secondo il listino già pubblicato, parte da 6 dollari al mese (3 per i nuovi iscritti) e arriva a 43 per il piano Pro. Alibaba però non ha chiarito quanto valga un credito in termini di consumo, quindi il confronto con la tariffa a pagamento resta difficile.
Come provarlo oggi, anche da Claude Code o Cursor
La strada più diretta passa dalla console di QwenCloud (Alibaba Cloud Model Studio, regione internazionale di Singapore). Dopo la registrazione generi una chiave API, e da quel momento il modello risponde all’identificativo qwen4-max. Siccome l’interfaccia è compatibile con quelle di OpenAI e Anthropic, nella maggior parte dei programmi basta cambiare indirizzo, credenziali e nome.
Per prima cosa salva la chiave di QwenCloud in una variabile d’ambiente, così non dovrai scriverla nei file di configurazione.
# macOS e Linux
export DASHSCOPE_API_KEY="la-tua-chiave"

# Windows (PowerShell)
$env:DASHSCOPE_API_KEY="la-tua-chiave"Claude Code
Claude Code si può configurare con l’endpoint compatibile con Anthropic, cioè l’indirizzo che riceve le richieste nello stesso formato usato da Claude. In questo modo l’assistente di programmazione resta identico, mentre a rispondere è Qwen4-Max.
export ANTHROPIC_BASE_URL="https://dashscope-intl.aliyuncs.com/apps/anthropic"
export ANTHROPIC_API_KEY="$DASHSCOPE_API_KEY"
claude --model qwen4-maxSu Windows le prime due righe diventano $env:ANTHROPIC_BASE_URL="https://dashscope-intl.aliyuncs.com/apps/anthropic" e $env:ANTHROPIC_API_KEY=$env:DASHSCOPE_API_KEY.
Codex di OpenAI
Codex, l’assistente da terminale di OpenAI, accetta fornitori esterni attraverso il file ~/.codex/config.toml, che su Windows si trova in C:\Users\<nome>\.codex\config.toml. Le versioni recenti dialogano solo con la Responses API, il formato più moderno di OpenAI, che Alibaba supporta per i suoi modelli Max. Aggiungi queste righe al file.
model_provider = "qwencloud"
model = "qwen4-max"

[model_providers.qwencloud]
name = "QwenCloud"
base_url = "https://dashscope-intl.aliyuncs.com/compatible-mode/v1"
env_key = "DASHSCOPE_API_KEY"
wire_api = "responses"Poi avvia codex come sempre. All’apertura può comparire un avviso sui metadati del modello mancanti, che però non blocca nulla e segnala solo che Codex non conosce in anticipo contesto e livelli di ragionamento di Qwen4-Max. Se la console ti assegna un indirizzo personale con l’ID del tuo spazio di lavoro, usa quello al posto di dashscope-intl.aliyuncs.com.
OpenCode
OpenCode, l’agente open source per il terminale, ha OpenRouter già integrato, e questa è la via più rapida. Installalo e avvialo con due comandi.
npm install -g opencode-ai
opencodeNella finestra di OpenCode digita /connect, scegli OpenRouter e incolla la chiave, poi con /models seleziona Qwen4-Max dall’elenco. Se preferisci fissarlo come modello predefinito, nel file ~/.config/opencode/opencode.json basta questa configurazione.
{
  "$schema": "https://opencode.ai/config.json",
  "model": "openrouter/qwen/qwen4-max"
}OpenRouter
OpenRouter raccoglie centinaia di modelli dietro un’unica chiave e un unico credito prepagato. Crei l’account, ricarichi qualche dollaro nella sezione Credits, generi una chiave nella sezione Keys e usi l’identificativo qwen/qwen4-max. Al momento non esiste una variante gratuita del modello, quindi ogni richiesta viene addebitata. Per una prova veloce dal terminale basta questo comando, che chiede una risposta con il ragionamento al livello minimo.
export OPENROUTER_API_KEY="la-tua-chiave-openrouter"

curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model":"qwen/qwen4-max","reasoning":{"effort":"low"},"messages":[{"role":"user","content":"Spiegami in tre righe come funziona un modello MoE"}]}'La stessa chiave funziona anche con Codex. Nel blocco visto sopra basta sostituire l’indirizzo con https://openrouter.ai/api/v1, la variabile con OPENROUTER_API_KEY e il modello con qwen/qwen4-max.
Una volta attivo il Token Plan, l’indirizzo per Claude Code e Codex sarà diverso e andrà copiato dalla pagina del tuo abbonamento. Se infine avevi configurato la versione di anteprima qwen4-max-preview, aggiorna il nome, perché verrà spenta dopo il 25 novembre.
Qwen4-Max non è il più brillante, ma si fa valere
Alibaba ha preso un modello già grande, ne ha ridotto il motore acceso a ogni parola e ha abbassato i prezzi, puntando in particolare sugli agenti che lavorano a lungo e consegnano lavori completi, non solo semplici risposte in chat. Per chi usa questi strumenti ogni giorno è una buona notizia, perché la concorrenza si traduce in più opzioni e costi in calo. Conviene quindi abituarsi a cambiare modello in base al lavoro, tenendo quello più potente per i problemi difficili e affidando a sistemi come Qwen4-Max le attività lunghe e ripetitive, dove il risparmio si accumula.
La partita più interessante, forse, si giocherà nelle prossime settimane con i modelli più piccoli della famiglia, quelli che Alibaba ha promesso di rilasciare in forma aperta. Se manterranno anche solo una parte delle capacità del fratello maggiore, saranno loro a portare Qwen4 sui computer di tutti i giorni.
Segui Gomoot
Le nostre recensioni e notizie, dove le cerchi già.