

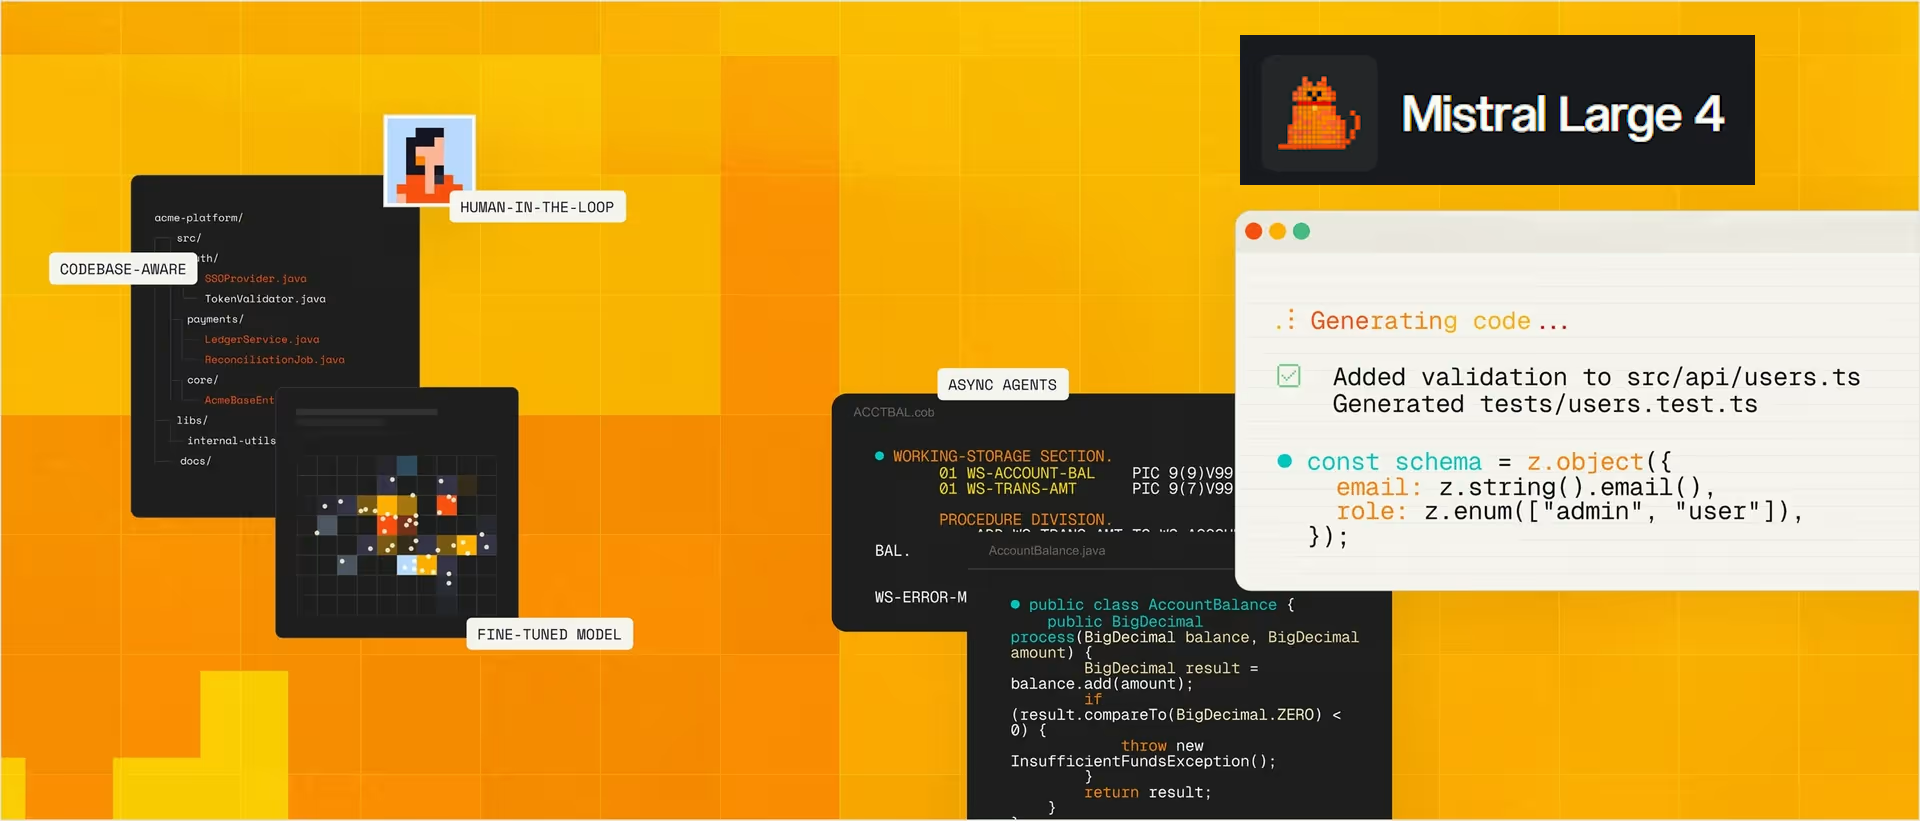
Dentro Mistral lo chiamano Le Chonk ovvero il «il ciccione», un soprannome scherzoso che allude alle dimensioni, e i numeri lo giustificano. Mistral Large 4 conta circa mille miliardi di parametri, ne attiva meno del 5% per ogni token ed è il modello più grande mai realizzato dalla società francese. Dal 6 ottobre è disponibile in anteprima pubblica tramite API, mentre i pesi scaricabili arriveranno a fine mese, dopo un periodo di verifiche di sicurezza con partner del settore informatico e autorità nazionali.
Mistral lo presenta come il miglior modello a pesi aperti degli Stati Uniti e dell’Europa nei benchmark aggregati e insiste su un aspetto preciso, cioè l’intera filiera europea, dall’addestramento sui propri server all’erogazione tramite Mistral Cloud.
Artificial Analysis lo colloca allo stesso livello di GPT-6 Luna e DeepSeek V4.1 Flash, modelli molto più economici, pur riconoscendogli il primato fuori da Stati Uniti e Cina. Large 4 interessa soprattutto ad aziende e pubbliche amministrazioni europee che cercano un’alternativa da installare in casa, oltre a chi lavora in sicurezza informatica e finanza.
Architettura MoE e visione nativa
Large 4 è un modello MoE, cioè mixture of experts, un’architettura che divide la rete in tanti blocchi specializzati e ne attiva solo una parte per ogni parola elaborata. Su circa 1.050 miliardi di parametri totali ne lavorano così 49 miliardi alla volta, 52 contando gli strati di ingresso e uscita, e questo mantiene i costi di calcolo vicini a quelli di un modello molto più piccolo. Mistral non ha ancora pubblicato il numero di esperti né lo schema di instradamento, dettagli che arriveranno insieme ai pesi.
Il modello è nativamente multimodale, con un codificatore visivo da 1,6 miliardi di parametri che gli permette di leggere foto, grafici e documenti, mentre le risposte restano solo testuali. L’API accetta ora fino a 100 immagini per richiesta, contro le 8 dei modelli precedenti, e supporta più di 160 lingue.
L’addestramento si è svolto su circa 3.800 chip Nvidia Grace Blackwell nei data center europei della società. Per la fase di apprendimento per rinforzo Mistral ha sviluppato un sistema che esegue decine di migliaia di prove in parallelo, con ambienti di programmazione, un motore di ricerca web e il controllo automatico dei risultati.
L’API supporta già output strutturati, chiamata di funzioni ed elaborazione in batch.
Primato fuori da Stati Uniti e Cina, ma lontano dai modelli frontiera
L’Intelligence Index di Artificial Analysis, che riunisce dieci prove su ragionamento, programmazione e lavoro d’ufficio, assegna a Large 4 38 punti. È lo stesso valore di GPT-6 Luna e uno in meno di DeepSeek V4.1 Flash, abbastanza per farne il modello più capace sviluppato fuori da Stati Uniti e Cina. La distanza dai modelli di frontiera resta però ampia, con i 52 di GPT-6.1 Sol, i 56 di Claude Sonnet 5.5 e i 58 di Opus 5.5.
Il terreno più favorevole è la sicurezza informatica. Nel Cyber Index di Artificial Analysis, che misura la capacità di trovare e correggere vulnerabilità, Large 4 ottiene 50 punti, come GLM-5.3-Flash e dietro ai 56 di Xiaomi MiMo-V2.6-Pro. Su CyberGym-E2E, la prova che va dalla scoperta di una falla fino alla sua correzione, arriva all’82%, davanti a MiMo-V2.6-Pro (79%) e GPT-6 Luna (78%).
Su GDP.pdf, che pone domande su documenti lunghi pieni di tabelle e grafici, sale al 19%, diciotto punti più di Large 3, anche grazie al limite di immagini più alto, ma resta dietro al 22% del modello cinese Kimi K3. Mistral rivendica inoltre il primato nella localizzazione di oggetti nelle immagini, con il 42% su Dense200 contro il 41% di GPT-6 Astra. La programmazione è il punto più debole. Su Terminal-Bench 4.0, che misura il lavoro autonomo da riga di comando, Artificial Analysis rileva il 26,8%, mentre Vals AI scende al 22,7%.
Sconto del 50% per due settimane
Il listino standard prevede 1,36 dollari per milione di token in input e 4,18 in output, con la lettura dalla cache a 0,14. Per le prime due settimane Mistral applica uno sconto del 50%, che porta le tariffe a 0,68 e 2,09 dollari, mentre l’elaborazione su server europei prevede un sovrapprezzo del 10%.
| Modello | Input ($/M token) | Output ($/M token) | Intelligence Index | Pesi |
|---|---|---|---|---|
| Mistral Large 4 | 1,36 | 4,18 | 38 | aperti |
| GPT-6 Luna | 0,10 | 0,50 | 38 | chiusi |
| DeepSeek V4.1 Flash | 0,15 / 0,30 | 0,60 / 1,20 | 39 | aperti |
Il modello è disponibile su Mistral Studio con il nome mistral-large-4 e in strumenti per sviluppatori come OpenCode, che applica lo stesso sconto. Su Hugging Face la pagina dei pesi è già pronta e indica come data il 31 ottobre. Nel frattempo partner selezionati e autorità nazionali ricevono una versione con filtri ridotti per le prove di red teaming, cioè gli attacchi simulati che servono a scoprire usi pericolosi prima della pubblicazione.
La fine di ottobre decide il valore di Le Chonk
Oggi Mistral Large 4 è un modello in anteprima che si può usare ma non ancora possedere (eseguire in locale), e il suo valore dipende dai file promessi per fine mese. Una volta scaricabile diventerà uno dei più grandi modelli aperti al mondo, addestrato ed erogabile interamente in Europa, con punti di forza nella sicurezza informatica, nella visione artificiale, nell’analisi di documenti e nel supporto a tante lingue.
Rimane un punto interrogativo sulla licenza, ancora sconosciuta, che dirà se l’apertura sarà ampia come quella di Large 3 o limitata da vincoli d’uso commerciale.
Se lavori in un’azienda o in un ente europeo che deve tenere dati e modelli entro i confini dell’Unione, conviene provarlo ora tramite API approfittando dello sconto e preparare l’infrastruttura per l’installazione locale. Per tutti gli altri, DeepSeek V4.1 Flash e GLM-5.3-Flash offrono risultati simili a una frazione del costo, e GPT-6 Luna resta la scelta più economica tra le soluzioni chiuse.