

Dall’arrivo di ChatGPT, a fine 2022, siamo abituati a un’intelligenza artificiale che parla. Le si scrive una domanda e lei risponde con un paragrafo, una lista, un documento intero. Jev, il primo modello pubblico della startup americana TypeSafe AI, fa l’esatto contrario. Non scrive nemmeno una parola, e restituisce soltanto una scelta accompagnata da una percentuale di sicurezza.
Va chiarito subito che Jev non è un modello di chat e non è pensato per conversare. È uno strumento rivolto soprattutto agli sviluppatori, che serve a eseguire molto più in fretta alcuni compiti AI ben precisi. Non sostituirà Claude, GPT o Gemini, e nella maggior parte dei casi lavorerà insieme a loro, prendendo le decisioni rapide in cui i modelli attuali sono lenti e costosi.
Mentre i grandi modelli si contendono il primato su chi parla meglio, chi scrive meglio e chi sembra più umano, Jev va completamente controcorrente. Jev è un modello AI che si occupa solo di dare giudizi e prendere decisioni nel modo più veloce possibile. Secondo TypeSafe è da 20 a 200 volte più rapido e da 40 a 400 volte più economico dei modelli più economici in circolazione, con un milione di token in ingresso a soli 0,042 dollari e i token in uscita del tutto gratuiti.
Per capire perché conta, basta guardare come si usa oggi l’AI nell’automazione. Si chiede a GPT, Claude o Gemini di valutare qualcosa, il modello scrive un lungo paragrafo e poi il programma deve andare a estrarre da quel testo il JSON, le etichette, i punteggi e l’azione successiva. Jev elimina del tutto il passaggio in cui il modello parla e spiega, e dice direttamente al software se scegliere A o B, con quale probabilità e con quale grado di sicurezza.
Gli ambiti in cui serve sono molto concreti, ovvero lo smistamento dei clienti, la revisione dei contenuti, l’instradamento dei compiti tra agenti, i sistemi di raccomandazione, il controllo dei rischi e il filtraggio dei segnali utili dentro grandi masse di dati. Jev è nato da un’osservazione semplice, cioè che la maggior parte delle chiamate a un modello AI non serve a far scrivere un saggio, ma a dare una quantità enorme di piccoli giudizi, anche migliaia al secondo. Ed è proprio questo che lo rende degno di molta attenzione.
A due giorni dall’uscita c’è chi gli ha fatto smistare email, chi lo ha messo al volante di un simulatore di guida, chi lo ha usato per far cliccare un agente dentro il browser alla velocità di una persona. Il post di lancio con il video di presentazione ha superato i 25 milioni di visualizzazioni, e nelle prime 36 ore l’azienda ha fatto entrare 140.000 persone dalla lista d’attesa.
Dietro il progetto c’è Diogo Almeida, ricercatore passato da OpenAI, dove ha lavorato ai metodi di addestramento che hanno insegnato ai modelli linguistici a seguire le istruzioni e che hanno portato a ChatGPT. Ha passato gli ultimi due anni a lavorare in segreto su Jev, presentato il 15 settembre 2026. La domanda da cui è partito, racconta, è perché modelli di conversazione così bravi non abbiano ancora portato a un’intelligenza generale (AGI).
Il paragone con i pensieri lenti e veloci
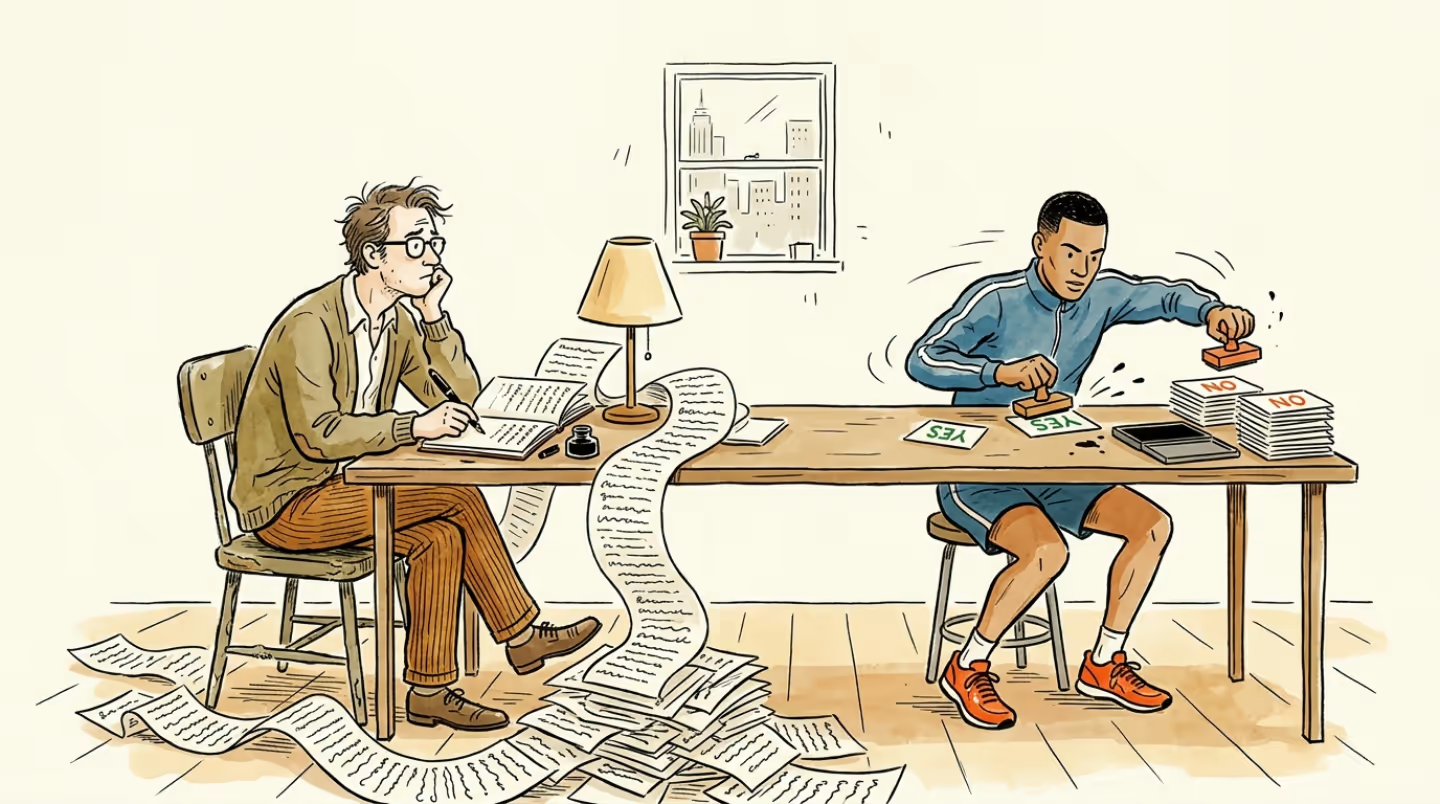
Per capire Jev, TypeSafe fa riferimento al libro Pensieri lenti e veloci dello psicologo premio Nobel Daniel Kahneman che divide il nostro modo di ragionare in due sistemi. Il Sistema 1 è quello rapido e istintivo che ci fa frenare davanti a un ostacolo o riconoscere un volto arrabbiato. Il Sistema 2 è quello lento, che usiamo per fare una moltiplicazione a due cifre o scrivere una lettera.
I grandi modelli linguistici come Claude, GPT o Gemini assomigliano al secondo. Producono il testo un pezzetto alla volta, e ogni pezzetto dipende da quelli scritti prima, quindi una risposta lunga richiede secondi e a volte minuti. TypeSafe chiama Jev un modello System One, cioè un modello costruito per il giudizio immediato. Non ragiona ad alta voce e non spiega le sue scelte, guarda la situazione e decide nel modo più veloce possibile.
Il nome dell’azienda TypeSafe lo spiega. In informatica un dato “tipizzato” ha una forma precisa e prevedibile, un sì o un no, un numero, una voce presa da un elenco. TypeSafe promette esattamente questo, cioè una risposta che un programma può usare subito, senza dover interpretare un testo scritto con parole sempre diverse.
Come si fa una domanda a Jev
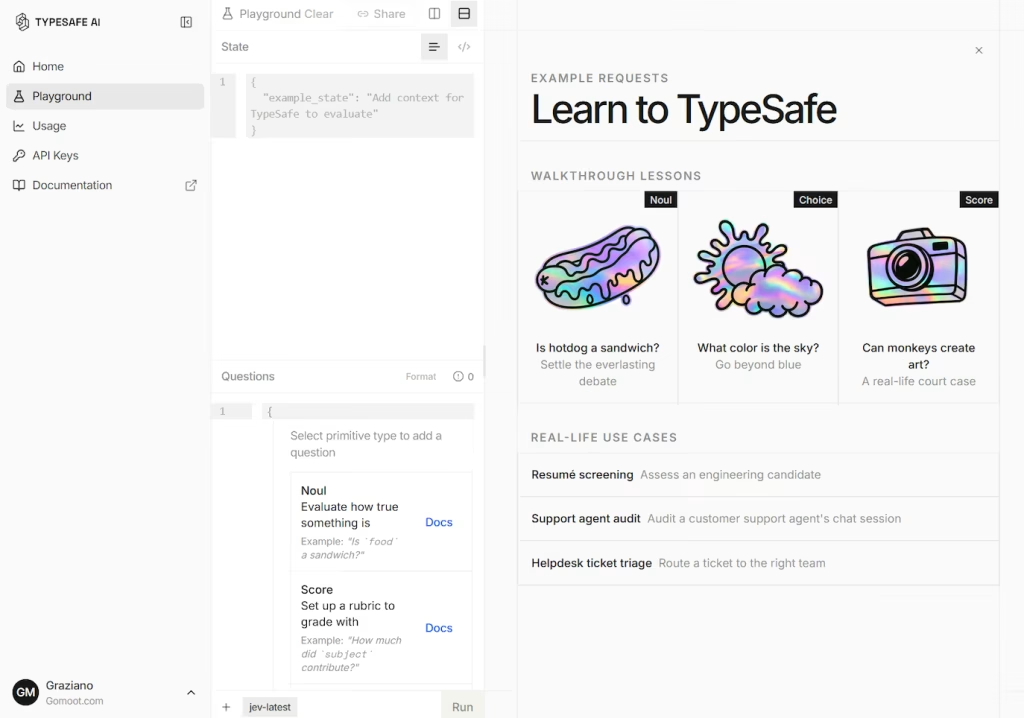
Con un chatbot si scrive una richiesta libera. Con Jev si preparano due cose, il contesto, cioè il testo o i dati da valutare, e una serie di domande con le risposte possibili già elencate. Le domande possono essere di tre tipi, che la documentazione chiama con nomi precisi.
- Noul. Una domanda a cui il modello risponde con la probabilità che un’affermazione sia vera o falsa.
- Choice. La scelta tra un elenco di opzioni, fino a un massimo di 255, per esempio a quale reparto girare una richiesta.
- Score. Un voto su una scala ordinata, per esempio quanto è arrabbiato un cliente, da calmo a furioso.
Per ogni domanda Jev restituisce la risposta scelta, la probabilità assegnata a ciascuna opzione e un grado di sicurezza complessivo. L’azienda sostiene che le probabilità siano calibrate, e una sicurezza più alta corrisponde a risposte più spesso corrette. È il risultato di un metodo di addestramento sviluppato in casa, chiamato RLCD, dall’inglese apprendimento per rinforzo per decisioni calibrate.
Per chi programma, questa logica in Python occupa poche righe. La libreria ufficiale si chiama typesafe-sdk, richiede Python 3.10 o successivo e una chiave API presa dalla console. L’esempio che segue riprende quello della guida rapida TypeSafe.
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()

risposta = client.system_one(
    state="Cerco di collegare il mio conto Stripe da tre giorni e non funziona. Sto perdendo vendite, aiutatemi subito.",
    questions={
        "reparto": Choice(
            instructions="Quale ufficio deve gestire la richiesta",
            criteria={
                "amministrazione": "Pagamenti o abbonamenti",
                "tecnico": "Errori o problemi di integrazione",
                "commerciale": "Prezzi o domande sull'account",
            },
        ),
        "irritazione": Score(
            instructions="Quanto appare irritato il cliente",
            criteria=["Calmo", "Irritato ma educato", "Molto arrabbiato"],
        ),
        "urgente": Noul(
            instructions="Il messaggio segnala urgenza o una scadenza",
        ),
    },
)
Perché è così veloce e così economico
Il segreto sta nel fatto che Jev non produce la risposta un pezzo alla volta. Un modello linguistico scrive un frammento di parola, lo rilegge, scrive il successivo, e il tempo cresce con la lunghezza del testo. Jev elabora il contesto e risponde a tutte le domande in parallelo, in un solo passaggio. TypeSafe dichiara tempi di risposta tra 70 e 500 millisecondi, contro i secondi o i minuti che servono ai grandi modelli per arrivare a una decisione paragonabile.
I prezzi spiegano il resto. Jev costa 0,042 dollari per milione di token in ingresso, cioè 42 dollari per un miliardo, mentre le risposte sono gratuite, perché secondo l’azienda sono troppo economiche per essere conteggiate. Tradotto in esempi, un milione di decisioni su testi da circa mille token costa solo 42 dollari.
Game changer per robotica e guida autonoma
La robotica e la guida autonoma sono i campi in cui Jev potrebbe farsi notare di più, perché lì una decisione che arriva tardi vale quanto una decisione sbagliata. La prova di Toran Bruce Richards lo mostra bene. Il simulatore non si ferma ad aspettare il modello, e un grande modello linguistico, che impiega secondi a rispondere, finirebbe fuori strada prima di aver deciso se sterzare. Jev invece risponde in pochi decimi di secondo, e la macchina resta in carreggiata.
Questo non significa che a breve Jev guiderà le automobili. Oggi Jev funziona in cloud e lavora solo su testo e dati strutturati, non sulle immagini. Sistemi come quello di Tesla prendono le decisioni a bordo, leggendo direttamente le telecamere, in tempi molto più brevi di qualsiasi chiamata via internet. Per entrare in un veicolo dovrebbe imparare a vedere, girare sull’hardware dell’auto e superare le verifiche di sicurezza che un sistema di guida richiede. Ci vorrà un po’ di tempo, ma nel campo dell’AI sappiamo bene che il ritmo è accelerato.
Il ruolo più plausibile, almeno all’inizio, è un gradino più in alto. Un robot in un magazzino o un braccio meccanico in fabbrica ha già i suoi sistemi per muoversi con precisione. Gli manca un modo rapido ed economico per scegliere cosa fare, per esempio quale pacco prendere per primo, se un oggetto è danneggiato, se fermarsi o proseguire. Jev può dare quella risposta con una probabilità allegata, e quando la sicurezza è bassa il sistema può rallentare o chiamare una persona. È il tipo di giudizio rapido che finora costava troppo tempo per affidarlo a un modello AI.
Smistare la posta e le richieste dei clienti
Uno degli usi che salta agli occhi è la classificazione delle email. Riley Brown ha mostrato Jev mentre ordina 500 email in pochi secondi, spendendo in tutto 3,5 centesimi di dollaro, e ha aggiunto che mille richieste costano 7 centesimi. Per una piccola azienda che riceve centinaia di messaggi al giorno, significa separare fatture, reclami, preventivi e pubblicità senza che nessuno debba leggerli uno per uno.
Lo stesso schema vale per i ticket di assistenza, gli avvisi di sicurezza, le fatture da registrare e i controlli sul lavoro degli agenti AI.
Nathan LeClaire su X ha pubblicato una ricetta per la ricerca semantica, cioè per estrarre le informazioni utili da grandi quantità di testo disordinato. Setacciare migliaia di documenti costa pochi centesimi.
Il browser e il computer guidati quasi senza lag
Gli agenti che usano il computer o il browser al posto nostro hanno un difetto noto a chiunque li abbia provati. Sono lenti, perché prima di ogni clic il modello deve guardare la pagina, pensare e scrivere la sua decisione. Jev si inserisce proprio lì, nel momento della scelta.
Gregor Zunic, tra i fondatori della libreria Browser Use, ha costruito un piccolo agente open source che a ogni passo passa a Jev la struttura della pagina e l’elenco delle azioni possibili. La ricerca di un volo ha richiesto 7 secondi e 0,0039 dollari, con il video mostrato a velocità reale. Quando serve scrivere del testo in un campo, entra in gioco un piccolo modello linguistico di riserva, perché Jev da solo non sa farlo.
Steve Krouse ha pubblicato una dimostrazione simile, con Jev collegato ai browser remoti di Kernel e una pagina da provare in prima persona.
Vlad Terin ha invece creato Jev Browser, un adattatore open source per gli strumenti di navigazione di Codex. La divisione dei compiti è netta, perché Codex pianifica il lavoro una volta sola e Jev sceglie l’elemento su cui cliccare a ogni passo, confrontando le pagine più grandi con un massimo di sei richieste in parallelo.
C’è poi un uso meno visibile ma utilissimo per chi lavora con più assistenti di programmazione. Lahfir ha collegato Jev a Claude Code per decidere a chi affidare ogni compito prima di delegarlo. I lavori meccanici vanno a Haiku, quelli che richiedono ragionamento ai sotto-agenti Opus, le implementazioni lunghe a un ambiente esterno. È come un vigile urbano che smista il traffico tra modelli di costo e intelligenza diversi.
Alan Daitch ha messo Jev a giocare a Tetris in modalità molto difficile. Ogni giocata ha richiesto circa 0,3 secondi, e in due minuti il modello ha sistemato 357 pezzi e completato 134 linee. Sempre parlando di giochi la stessa TypeSafe aveva già mostrato Jev giocare a Doom in tempo reale, con dieci decisioni al secondo e un costo di circa 7 dollari l’ora.
Cosa non sa fare Jev
Jev ha limiti precisi; il primo è ovvio, perché non genera testo. Non risponde a una email, non riassume un documento, non scrive codice. Per tutto questo serve ancora un modello linguistico, e il modo sensato di usarlo è affiancarlo, non sostituirlo.
Il secondo limite riguarda l’intelligenza. Senza la possibilità di pensare più a lungo sui problemi difficili, come fanno i modelli di ragionamento, Jev resta più adatto a giudizi rapidi che a questioni complesse.
Il terzo limite è tecnico. Le opzioni per una singola scelta arrivano al massimo a 255, oltre si devono spezzare le domande in due passaggi, e per ora il modello lavora solo su testo e dati strutturati, non sulle immagini.
La collocazione di Jev
Jev non sostituisce i modelli linguistici né il flusso di lavoro esistente: li affianca. In pratica classifica, smista la posta, sceglie il pulsante, affida il compito al modello adatto, e quando non è sicuro lo dice con un numero.
In sintesi Jev:
- è un modello linguistico nel senso che capisce il linguaggio naturale. Legge email, pagine web e descrizioni, e le istruzioni gli si danno in parole.
- non è un LLM generativo, perché non produce testo.
- in base al tipo di compito è un modello discriminativo: sceglie tra risposte date invece di crearne di nuove. Appartiene alla stessa famiglia dei classificatori, ma molto più flessibile, perché le categorie e le domande si cambiano a ogni richiesta senza riaddestrarlo.
Chi gestisce un servizio clienti, una casella email affollata o un agente che naviga sul web ha già un posto dove provarlo. Chi invece cerca un assistente con cui parlare deve continuare a usare Claude, GPT o Gemini, perché Jev non sa rispondere nemmeno a un saluto.
Jev è in accesso anticipato. Ci si iscrive alla lista d’attesa dal sito di TypeSafe e, una volta ammessi, si ottiene la chiave API dalla console, che include un’area di prova dove fare domande senza scrivere codice. Per gli sviluppatori c’è la libreria Python già vista, e il modello è disponibile anche su Vercel AI Gateway con il nome typesafe-ai/jev.