



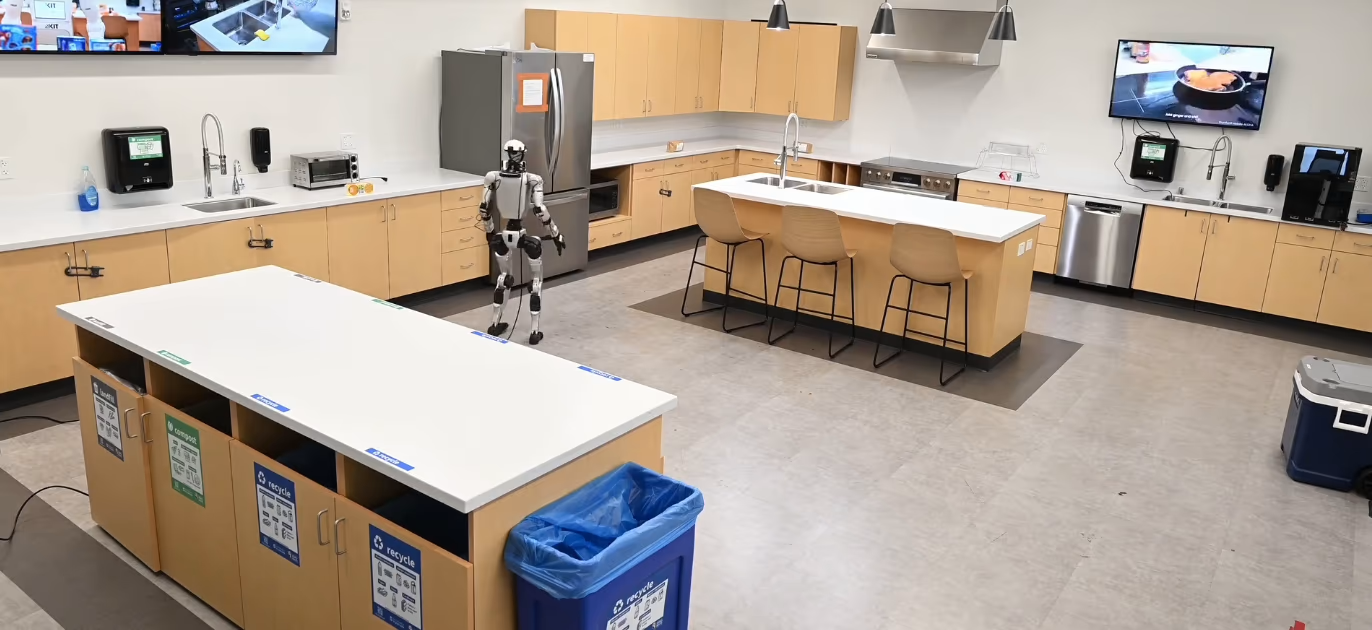
Chiedere a un robot di riordinare la cucina sembra una richiesta banale. Per una macchina, però, significa decidere cosa tenere e cosa buttare, ricordare dove si trovano oggetti che non vede più e alternare più volte camminata e presa senza perdere l’equilibrio. HomeBody, l’esperimento condotto dal Movement Lab di Stanford insieme a Caltech in una cucina dell’ateneo, affronta il problema in modo diverso dal solito.
Su un Unitree G1, un umanoide alto circa 1,3 metri, il gruppo ha collegato direttamente GPT-6 Astra, il modello di OpenAI aperto al pubblico a inizio mese, a una piccola libreria di abilità motorie, senza addestrare alcuna rete specifica per quella stanza. Il robot esplora l’ambiente, se ne costruisce un gemello digitale e poi esegue ordini in linguaggio naturale, come recuperare un farmaco chiuso in un cassetto visto durante il giro iniziale.
I risultati del test sono raccolti in una pagina di progetto pubblicata a fine settembre dal laboratorio, con i video delle due prove complete e delle singole abilità, un visore 3D che sovrappone la scansione laser della stanza alla cucina ricostruita, una sezione di domande tecniche e l’elenco dei limiti. Studio scientifico e codice sono indicati come in arrivo.
Il modello linguistico prende il posto del cervello intermedio
Molti umanoidi autonomi seguono oggi uno schema a tre livelli. In cima c’è un VLM (vision-language model), cioè un sistema che capisce immagini e testo, che interpreta la scena e l’istruzione. Sotto lavora un VLA, sigla che aggiunge l’azione alla formula precedente, cioè una rete addestrata a trasformare ciò che vede e le istruzioni in movimenti, e alla base un controllore che coordina tutto il corpo e mantiene l’equilibrio.
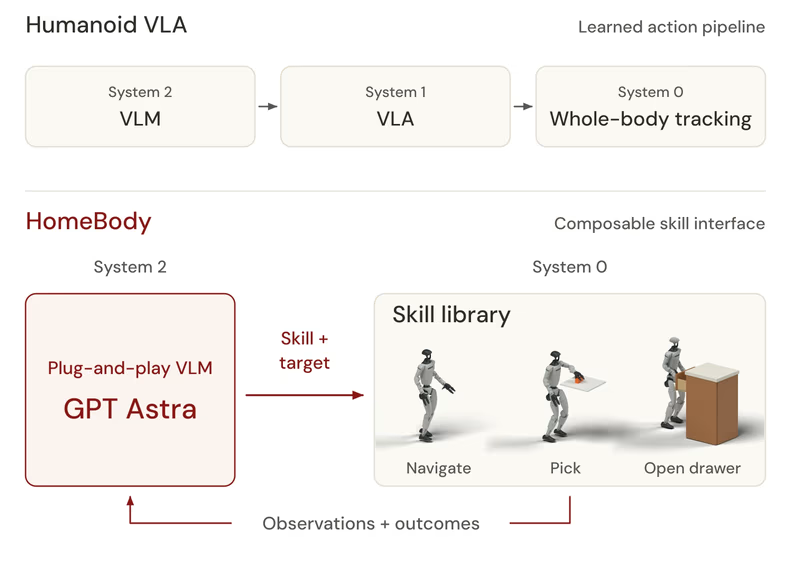
Il livello intermedio è quello più costoso, perché richiede enormi quantità di dimostrazioni, spesso registrate con un operatore umano che guida il robot a distanza, e tende a funzionare male negli ambienti che non ha mai incontrato.
HomeBody cerca di eliminare proprio quel livello. Il modello in cima alla catena sceglie un’abilità e il relativo bersaglio attraverso una chiamata a uno strumento, lo stesso meccanismo con cui un chatbot avvia una ricerca web o esegue un calcolo. L’abilità, a sua volta, pianifica e compie il movimento, poi restituisce l’esito, compreso il motivo di un eventuale fallimento, e GPT-6 Astra decide il passo successivo. Di conseguenza il robot diventa, in pratica, una periferica dell’AI.
Il vantaggio più evidente riguarda gli aggiornamenti. Quando esce un modello più capace, il robot ragiona meglio senza bisogno di raccogliere nuovi dati o di riaddestrare nulla. Nel codice della pagina di progetto, infatti, la parte di ragionamento è descritta come sostituibile a caldo, con il supporto dichiarato per Claude, Gemini, DeepSeek, Qwen, Mistral e modelli a pesi aperti. Tuttavia tutte le prove registrate usano soltanto GPT-6 Astra in remoto, quindi per ora non esiste un confronto che dica quanto regga l’architettura con un modello più piccolo o eseguito in locale.
Tre fasi per insegnare una stanza al robot
La messa in servizio parte da un’esplorazione guidata. Al robot si assegna un ruolo con una frase semplice, qualcosa come «sei un robot da cucina, esplora lo spazio», e da lì è lo stesso GPT-6 Astra a scegliere i punti di osservazione più utili.
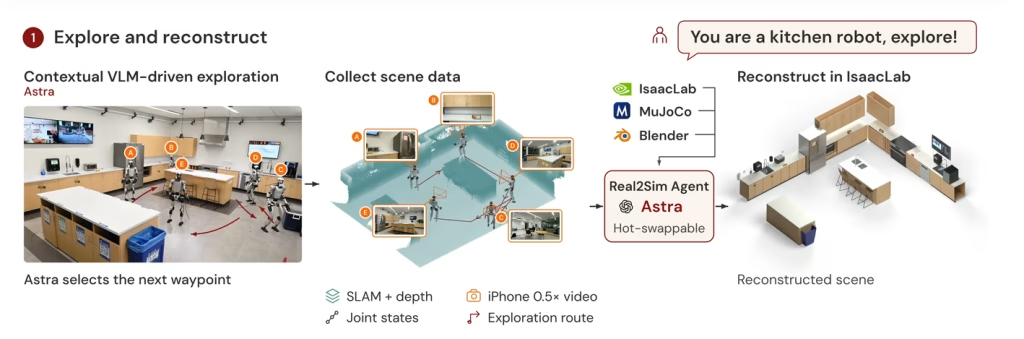
Nella seconda fase, chiamata Real2Sim, GPT-6 Astra lavora come agente e ricostruisce la cucina dentro NVIDIA Isaac Sim, un simulatore fisico molto usato in robotica. Con il solo video, l’agente dovrebbe stimare le dimensioni della stanza dall’aspetto delle cose. Il robot però registra anche le scansioni del LiDAR, un sensore laser che misura le distanze reali, e questi dati vincolano la geometria. Per un robot che deve arrivare a pochi centimetri da un bancone, la differenza è molto importante.
Per orientarsi durante il lavoro, il G1 usa Super Odometry e allinea la propria mappa al modello simulato con la registrazione ICP (iterative closest point), un algoritmo che sovrappone due nuvole di punti finché combaciano. Ogni fotogramma salvato conserva la posizione e una breve descrizione testuale, e questa è la vera memoria spaziale del sistema.
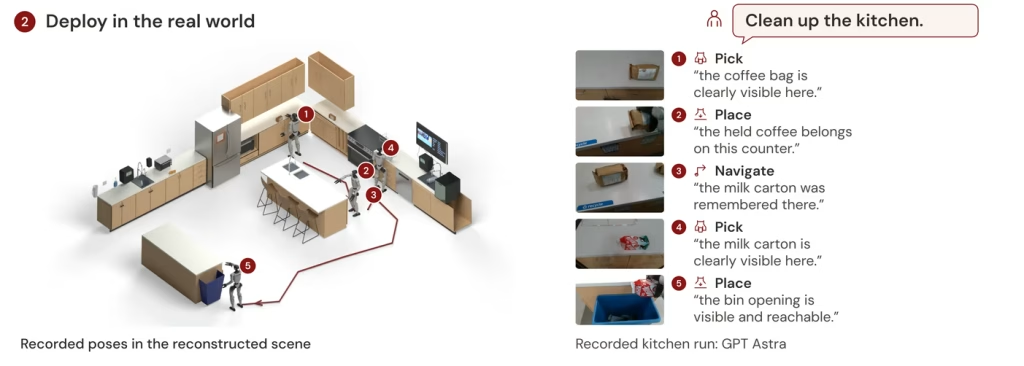
Nella terza fase basta un ordine in linguaggio naturale. Nella prova del farmaco la richiesta è volutamente vaga, del tipo «ho dimenticato la medicina, me la prendi?». Il robot non la vede, recupera dalla memoria il cassetto giusto, lo apre con la mano destra, porge la confezione alla persona e, con la mano sinistra, butta un cartone scaduto.
Cinque abilità e un’interfaccia comune
Il vocabolario d’azione di HomeBody è volutamente ridotto e si compone di cinque comportamenti che condividono lo stesso formato per bersagli e risultati:
- Presa. Afferra e solleva l’oggetto indicato nell’immagine della telecamera.
- Rilascio. Porta ciò che tiene in mano fino a un punto di deposito nello spazio.
- Apertura cassetto. Si allinea alla maniglia, la aggancia e cammina all’indietro tirandola verso di sé.
- Prelievo interno. Raggiunge il fondo del vano già aperto e solleva ciò che contiene oltre il bordo.
- Navigazione. Segue un percorso pianificato verso una destinazione della mappa ricostruita.
La presa è l’abilità più interessante da smontare. Il modello indica un punto sull’immagine, con coordinate normalizzate da 0 a 1000, e specifica quale mano usare. Quella coordinata guida la segmentazione di SAM 2, che ritaglia l’oggetto, mentre Fast-FoundationStereo ricava la profondità dalle due immagini della telecamera stereo Intel RealSense D435i montata sulla testa. Dalla forma tridimensionale ottenuta si calcola la presa in modo analitico, senza reti addestrate allo scopo, e il braccio segue una traiettoria a minimo jerk, cioè con variazioni di accelerazione il più possibile dolci, verificata contro le collisioni.
Durante l’avvicinamento il bersaglio può spostarsi nell’inquadratura. Per questo il sistema lo segue con SAMURAI, un algoritmo di tracciamento basato su SAM 2.1, e corregge la mira in tempo reale con l’asservimento visivo, senza interpellare ogni volta il modello remoto. Se la mano si chiude a vuoto, l’abilità prova un’altra presa o sposta i piedi e ripianifica, ma entro un numero limitato di tentativi, oltre il quale passa la palla ad Astra con la spiegazione dell’errore.
L’equilibrio, invece, è affidato ad AMO (Adaptive Motion Optimization), un controllore appreso già pubblicato che adatta le gambe ai movimenti della parte superiore del corpo. Braccia e mani ricevono comandi a 250 Hz, mentre AMO si aggiorna a 50 Hz, un ciclo ogni cinque. Infine, l’interfaccia comune permette di aggiungere abilità proprie, che si tratti di una rete neurale, di un algoritmo classico o di un altro controllore.
Come appare una chiamata e cosa c’è oggi su GitHub
Il codice non è ancora disponibile. Il repository Stanford-TML/homebody contiene per ora soltanto i file della pagina di progetto, con l’indicazione che i sorgenti arriveranno più avanti, e anche l’articolo scientifico è segnato come in preparazione. Se vuoi seguirne gli aggiornamenti, puoi clonare il repository e controllare periodicamente i nuovi commit:
git clone https://github.com/Stanford-TML/homebody.git
cd homebody
# controlla le novità nei giorni successivi
git pull
git log --oneline -5
Per capire la logica, però, la descrizione pubblicata basta a ricostruire la forma delle chiamate. Lo schema che segue è un esempio illustrativo scritto da me a partire dai parametri documentati, non codice ufficiale. Ogni abilità riceve un bersaglio adatto al proprio compito:
[
  {
    "skill": "navigate",
    "goal_xy_m": [2.4, -1.1],
    "facing_point_xy_m": [3.0, -1.1]
  },
  {
    "skill": "pick",
    "hand": "right",
    "image_point_0_1000": [512, 640]
  },
  {
    "skill": "place",
    "hand": "right",
    "release_target_torso_frame_m": [0.45, -0.10, 0.05],
    "release_distance_m": 0.03
  }
]
La navigazione usa coordinate della mappa in metri e un punto verso cui girarsi, la presa un pixel e una mano, il rilascio una posizione nello spazio misurata rispetto al busto del robot. Il dettaglio da notare è che il modello non conosce nulla di motori, angoli o traiettorie.
Di conseguenza puoi sostituire un’abilità con una versione migliore senza toccare la parte di ragionamento, esattamente come si aggiorna una libreria in un programma. Anche la scelta della mano, destra o sinistra, spetta al modello, ed è così che nella prova del farmaco il robot apre il cassetto con una mano e butta il cartone con l’altra.
Hardware, costi e autonomia sul campo
Il G1 pesa circa 35 kg con la batteria, è alto 132 cm in piedi e monta un pacco batteria da 9000 mAh. Unitree indica un’autonomia di un paio d’ore. Con compiti che nella realtà durano fra i 10 e i 16 minuti (i video pubblicati sono accelerati), una carica basterebbe in teoria per un numero di sessioni compreso fra sette e dodici, ma il gruppo segnala che durante l’uso prolungato si surriscaldano i servomotori delle dita, e questo accorcia il lavoro prima della batteria.
Il G1 base parte da 13.500 dollari, ma non include le mani articolate. Il robot delle prove usa mani a tre dita del tipo offerto da Unitree solo nelle versioni EDU per la ricerca, con prezzo su richiesta e in genere molto superiore alla cifra d’ingresso.
La mappa della stanza conta più di tutto
Per un robot svolgere azioni in uno spazio sconosciuto senza addestramento non è un compito semplice. Il test di Stanford ha mostrato che l’uso combinato di memoria spaziale, modelli multimodali e librerie di abilità potrebbe rendere i robot più flessibili e capaci di seguire istruzioni quotidiane formulate in linguaggio naturale.
Il lavoro mostra una direzione promettente e dimostrazioni convincenti di autonomia su compiti lunghi e composti da molti passaggi, ma non costituisce ancora una soluzione generale per l’impiego domestico dei robot umanoidi. Un robot di 35 kg che si muove tra sgabelli e persone richiede garanzie di sicurezza che un prototipo non sa ancora offrire. C’è poi una questione che riguarda la casa più della robotica: ogni decisione del robot passa dai server di OpenAI, con quello che comporta per privacy, costi continui e funzionamento senza connessione.
La parte più riuscita non è la manipolazione, ma la combinazione fra memoria spaziale e ragionamento, quella che permette al robot di sentire «ho dimenticato la medicina» e di andare dritto al cassetto giusto. Il robot più utile dei prossimi anni sarà quello che saprà orientarsi senza problemi dentro casa.


