




Il 21 settembre 2026 xAI ha rilasciato Grok 4.7, quaranta giorni dopo Grok 4.6 e con trentuno giorni di ritardo sulla prima data promessa dal fondatore. Il modello si colloca al vertice della gamma di SpaceXAI, dedicato alla programmazione, al lavoro agentico e alle attività professionali , e succede a Grok 4.6.
L’annuncio ufficiale lo descrive come costruito su una base più grande, addestrato con una fase di apprendimento per rinforzo più lunga e orientata a compiti che durano ore, con una capacità migliore di verificare il proprio lavoro. Elon Musk aveva promesso un modello da 2,1 trilioni di parametri nutrito con i dati di ingegneria di SpaceX, ma la scheda ufficiale non conferma né il numero di parametri né la presenza di quei dati. La finestra di contesto resta a 500.000 token e il taglio della conoscenza è fermo a maggio 2026 anche se con capacità molto avanzate di ricerca di informazioni sia sul web che su X.
E’ pensato per chi programma con agenti autonomi, chi costruisce flussi che girano a lungo e chi si occupa di ingegneria, diritto o analisi documentale. Il punto di forza dichiarato non è il primato assoluto, che la stessa tabella di xAI non rivendica, bensì il rapporto tra capacità e spesa, perché il modello arriva vicino ai sistemi di punta costando una frazione.
Più lavoro per ogni risposta
La finestra resta a 500.000 token, l’ingresso accetta testo, immagini e file come i PDF, mentre l’uscita produce solo testo. Il parametro dello sforzo di ragionamento accetta quattro livelli, da low fino a xhigh, con high come predefinito. Sono disponibili la chiamata di funzione e gli output strutturati tramite schema JSON.
La novità di questo modello arriva dal modo in cui lavora. xAI riferisce miglioramenti nei compiti che richiedono molte ore, ovvero la capacità di restare concentrato su un incarico lungo, di riprenderlo dopo un errore invece di ricominciare e di controllare i propri risultati con più rigore. È il tipo di miglioramento che si nota lungo un lavoro articolato, per esempio quando affidi a un agente la costruzione di un progetto lasciandolo procedere in autonomia.
Qui però serve una precisazione che pesa. Secondo Artificial Analysis il modello consuma 81.000 token di ragionamento per completare un compito del suo indice, contro i 36.000 di Grok 4.6, cioè più del doppio. A parità di prezzo per token, un incarico che prima costava un’unità ora ne costa circa due, perché il modello pensa più a lungo per guadagnare il punteggio. La stessa fonte misura una velocità intorno ai 188 token al secondo e circa sette minuti per ogni compito dell’indice.
Le prime prove sul campo raccontano lo stesso problema. Un test pubblico di BridgeBench ha fatto girare lo stesso incarico grafico sui due modelli, e Grok 4.7 è costato 0,35 dollari in quindici minuti contro i 0,23 dollari in dieci minuti del predecessore, con un risultato giudicato ancora acerbo per il lavoro reale. Non a caso Cursor mantiene disponibile anche Grok 4.6 per chi non ha bisogno del ragionamento aggiuntivo. Un dato positivo arriva invece sulle allucinazioni, scese dal 34% al 29% rispetto al predecessore, quindi il modello sbaglia un po’ meno quando non conosce una risposta.
Cosa dicono i benchmark
I risultati vanno letti sapendo cosa misura ogni prova, e tenendo presente che la tabella è pubblicata da xAI. La prova più netta è Terminal-Bench 4.0, che valuta la capacità di lavorare in un terminale su compiti lunghi. Qui Grok 4.7 segna 38,0, quasi il doppio del 20,3 di Grok 4.6, e questo è il salto che conta per chi fa lavoro agentico prolungato. Su una prova del genere un punteggio del 38% significa però che quasi due compiti su tre non arrivano in fondo, quindi la strada verso l’autonomia piena resta lunga.
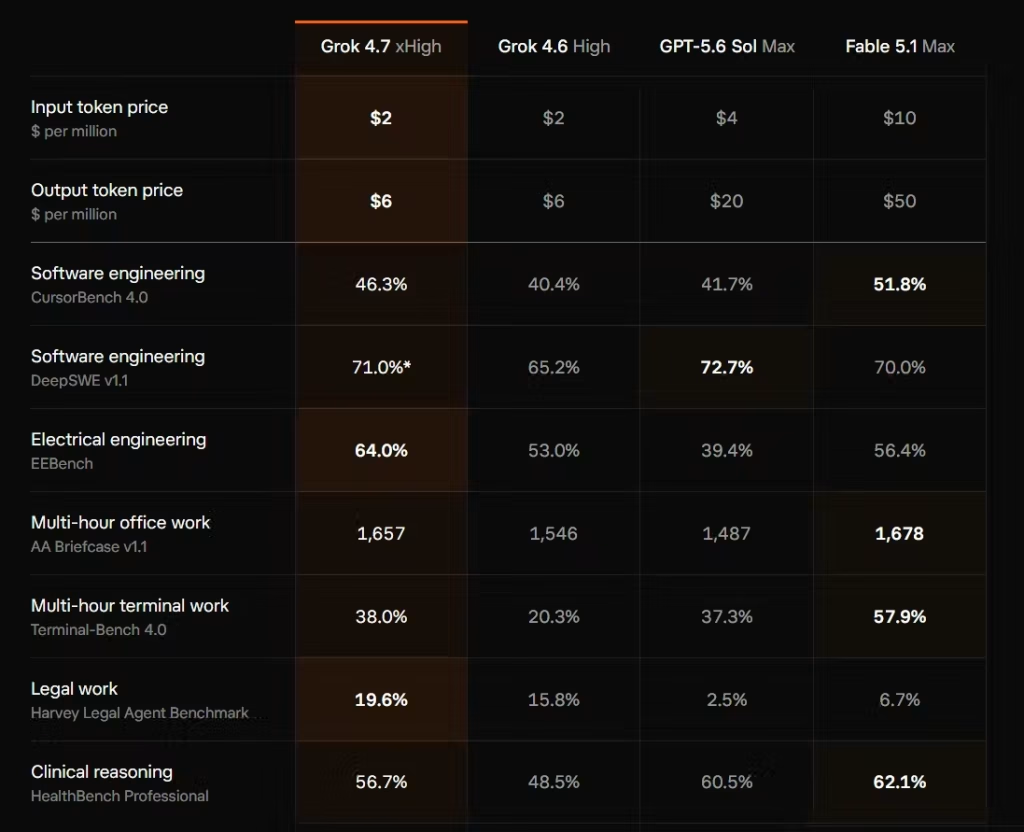
Il secondo dato da capire è il confronto con i rivali. Contro Claude Fable 5.1 il modello vince nettamente su EEBench, la prova di ingegneria elettrica, con 64,0 contro 56,4, e stravince sul Harvey Legal Benchmark con 19,6 contro 6,7. Perde però sui due terreni della programmazione più seguiti, cioè CursorBench con 46,3 contro 51,8 e la stessa Terminal-Bench dove Fable arriva a 57,9. In pratica il modello di xAI è forte dove il rivale è debole e viceversa. Contro GPT-5.6 Sol invece guida su quattro prove delle sette.
Sul GDPval, che misura il lavoro professionale di conoscenza, Grok 4.7 segna 1695 punti di Elo contro i 1735 di Fable 5.1, quindi resta dietro. Musk aveva scritto ad agosto che il modello avrebbe superato tutti gli altri, mentre la tabella di xAI parla di sistema altamente competitivo nella sua categoria, che è cosa diversa. La lettura indipendente di Artificial Analysis lo colloca al sedicesimo posto su 655 modelli del suo indice di intelligenza, con un punteggio di 46.
Prezzi, promozioni e dove provarlo subito
Il listino è identico a quello di Grok 4.6. Sull’API ufficiale di xAI il prezzo è di 2 dollari per milione di token in ingresso, 0,50 dollari per l’ingresso servito dalla cache e 6 dollari in uscita, per richieste sotto i 200.000 token. Oltre quella soglia le tariffe raddoppiano a 4, 1 e 12 dollari, e la maggiorazione si applica all’intera richiesta. Esiste una variante veloce al doppio della velocità ma al doppio del prezzo. Il senso della frase di lancio, cioè metà del prezzo dei modelli comparabili, sta nel confronto con i rivali, non col predecessore, dato che Fable 5.1 costa 10 e 50 dollari e GPT-5.6 Sol 4 e 20.
Il punto interessante è che sulle piattaforme di terze parti il modello costa già meno del listino ufficiale. OpenRouter lo serve a 1,60 e 4,80 dollari con instradamento automatico tra più fornitori, mentre Vercel applica uno sconto del 40% fino al 27 settembre, che porta le tariffe a 1,20 e 3,60 dollari e riguarda anche gli agenti fx ed eve.
Sul fronte della disponibilità il modello è arrivato al lancio su Cursor, Grok Build e l’API, ed è comparso in giornata anche su GitHub Copilot e sul gateway di Vercel. Una nota per chi usa la chat pubblica, al momento del stesura articolo la pagina degli abbonamenti citava ancora Grok 4.6, quindi conviene verificare quale modello risponde nel proprio account.
Il numero di versione dice meno del contesto
Grok 4.7 è un caso in cui il salto reale sta nella struttura più che nella cifra, ma la promessa che lo accompagnava era più grande di ciò che ha consegnato. Il modello non supera tutti gli altri, come era stato annunciato, e sugli indici indipendenti resta dietro alla concorrenza sulla capacità generale. Ridefinisce però il rapporto tra spesa e risultato proprio dove serve, cioè sui carichi agentici lunghi, e lo fa senza alzare il prezzo del predecessore.
Se sei già su Grok 4.6, il passaggio è un semplice cambio di identificativo alla stessa tariffa, con una tabella che promette guadagni su ogni riga e il salto più utile su Terminal-Bench. Se stai scegliendo un modello, Grok 4.7 è una buona opzione per rapporto qualità-prezzo. Se invece ti serve la massima capacità sui compiti più difficili, i modelli di punta restano avanti. La cautela principale riguarda i benchmark, tutti firmati dal produttore, quindi il consiglio resta misurare sui tuoi carichi prima di decidere.