

OpenAI ha presentato il 22 settembre GPT-6 Sol e GPT-6 Luna, i due modelli che completano la famiglia GPT-6 sotto l’ammiraglia GPT-6 Astra. L’annuncio è arrivato circa novanta minuti dopo quello di Claude Opus 5.5 e segue una linea precisa, cioè trasferire buona parte dei progressi del modello di punta in versioni più rapide ed economiche, pensate per lavorare su larga scala.
Sol sostituisce GPT-5.6 Sol come proposta per la programmazione e i flussi di lavoro professionali complessi, mentre Luna prende il posto di GPT-5.6 Luna nella fascia dedicata ai grandi volumi, come riassunti, estrazione di dati e automazioni ripetitive.
Il dettaglio che salta all’occhio è il prezzo, dimezzato rispetto alla generazione precedente. Luna costa 0,10 dollari per milione di token in input e 0,50 in output, cifre che fino a poco tempo fa appartenevano quasi solo ai modelli a pesi aperti cinesi. È qui che nasce l’interesse della novità, perché DeepSeek, Alibaba, Z.ai e Xiaomi hanno costruito il proprio successo internazionale offrendo buone prestazioni a costi minimi.
Con Luna, OpenAI prova a riprendersi quel mercato con un modello proprietario, multimodale e dotato di una finestra di contesto da oltre un milione di token. Si rivolge a sviluppatori, aziende che automatizzano processi e a chi usa ChatGPT gratuitamente, che da oggi può provarlo nell’app desktop.
Cache più efficiente e ragionamento regolabile
OpenAI non ha diffuso dettagli sull’architettura né sul numero di parametri, e si limita a spiegare che Sol e Luna nascono con metodi simili a quelli usati per addestrare Astra. Entrambi sono modelli di ragionamento, cioè elaborano una catena di passaggi interni prima di rispondere, e permettono di regolare il reasoning effort, cioè l’intensità della riflessione, su più livelli fino a max. Luna accetta testo e immagini in ingresso, offre una finestra di contesto di 1,05 milioni di token e può produrre al massimo 128.000 token in una sola risposta.
La parte più interessante riguarda però l’infrastruttura. Il taglio dei prezzi nasce, secondo OpenAI, da una gestione più efficiente della cache dei prompt e dell’inferenza, cioè della fase in cui il modello produce le risposte. Questo meccanismo conserva le parti di testo già elaborate, come istruzioni di sistema o documenti ricorrenti, e le fa pagare il 90% in meno alla lettura successiva, per Luna appena 0,01 dollari per milione di token.
Con la nuova generazione aumenta la frequenza con cui la cache viene sfruttata in automatico e gli sviluppatori possono indicare punti di interruzione espliciti per stabilire dove termina il prefisso da conservare. Soprattutto, diventa possibile cambiare il livello di ragionamento o attivare gli strumenti senza invalidare quanto memorizzato. Arrivano inoltre una dashboard di monitoraggio e un sistema di diagnostica per capire perché una richiesta non sfrutta la cache.
Sul piano dell’affidabilità OpenAI dichiara che Sol commette grosso modo la metà degli errori fattuali del predecessore, mentre Luna, ai livelli di ragionamento più alti, raggiunge l’accuratezza di GPT-5.6 Sol a circa un centesimo del costo.
Sette centesimi per compito, i punti forti e le regressioni di Luna
Per collocare Luna nel mercato conviene partire da DeepSWE v1.1, una prova che chiede al modello di correggere bug reali all’interno di repository software, verificando la soluzione con la suite di test del codice. Luna al massimo livello di ragionamento risolve il 66,6% dei problemi, cioè due su tre, contro il 68,8% di Sol, il 66% di Claude Opus 5 e il 69,9% di Fable 5, modelli con un listino decine di volte più alto.
Il secondo riferimento è OSWorld 2.0, dedicato all’uso del computer attraverso l’interfaccia grafica, tra finestre, menu e applicazioni. Qui Luna ottiene il 58,1%, sopra GPT-5.6 Sol a un decimo del costo, mentre Sol arriva al 60,5% e Astra resta in testa con il 72,6%. Sol si distingue anche su AutomationBench, che valuta la capacità di portare a termine processi aziendali su 47 strumenti reali: con il 33,2% supera Fable 5.1 (31,4%) a 0,27 dollari per attività.
Leggendo le misurazioni indipendenti di Artificial Analysis Luna al livello max ottiene 37 punti nell’Intelligence Index, in linea con GPT-5.6 Luna, ma il costo per completare ogni prova scende da 0,18 a 0,07 dollari.
Il miglioramento più netto riguarda le allucinazioni, cioè le risposte inventate: il tasso cala dal 93% al 77% perché il modello preferisce ammettere di non sapere. Non mancano però alcune regressioni, come la perdita di 75 punti Elo su GDPval-AA, dedicato al lavoro d’ufficio, e il leggero calo nel Coding Agent Index, dove Luna si ferma a 41 contro i 43 del predecessore. Sol, invece, sale a 57 con un costo per attività dimezzato.
Un esempio pratico arriva da Bridgebench, che su X ha chiesto a quattro modelli di creare una scena 3D con il lancio di un razzo, e Luna ha completato il lavoro in 65 secondi spendendo meno di un centesimo, contro 1,52 dollari e 12 minuti di Claude Opus 5.5.
Listino dimezzato e sfida aperta a DeepSeek, Qwen, GLM e MiMo
Le tariffe API di GPT-6 Luna scendono a 0,10 dollari per milione di token in input e 0,50 in output, contro i 0,20 e 1,20 di GPT-5.6 Luna, mentre GPT-6 Sol passa a 2 e 10 dollari dai precedenti 4 e 20. Entrambi sono disponibili da subito nell’API, in ChatGPT Work e in Codex per gli abbonamenti Plus, Pro, Business, Enterprise ed Edu, mentre chi usa i piani Free e Go può provare Luna nell’app desktop.
Su GitHub Copilot Luna arriva già dal piano Pro e Sol da Pro+ in su, mentre su Vercel AI Gateway esiste anche una variante Fast di Luna a 0,20 e 1 dollaro, con circa due secondi di attesa per il primo token. Agli abbonati Plus, Pro e Business OpenAI ha inoltre concesso un azzeramento facoltativo dei limiti d’uso.
Il confronto più utile riguarda i modelli cinesi a pesi aperti, che fino a oggi dominavano la fascia low cost.
| Modello | Input ($/M token) | Output ($/M token) | Intelligence Index | Pesi |
|---|---|---|---|---|
| GPT-6 Luna | 0,10 | 0,50 | 37 | chiusi |
| DeepSeek V4.1 Flash | 0,15 / 0,30 | 0,60 / 1,20 | 39 | aperti (MIT) |
| Qwen3.8-Flash-Next | 0,15 | 0,47 | 40 | aperti |
| MiMo-V2.6-Pro | 0,43 | 0,87 | 46 | aperti (MIT) |
| GLM-5.3 | 1,40 | 4,40 | 45 | aperti |
Per DeepSeek il primo valore vale fuori dagli orari di punta, il secondo nelle fasce più richieste. Luna ha il prezzo d’ingresso più basso e il costo per attività più contenuto tra i modelli con il dato disponibile, circa la metà di MiMo-V2.6-Pro e un quinto di Qwen3.8-Flash-Next.
I modelli cinesi rispondono però con più punti nell’indice, fino ai 46 di MiMo, e soprattutto con pesi scaricabili, che permettono di installarli sui propri server, adattarli con un addestramento aggiuntivo e tenere i dati in casa. Se ti servono grandi volumi di compiti verificabili, Luna è oggi la scelta più economica, mentre se contano riservatezza e pieno controllo le soluzioni aperte restano più adatte.
Pacific Skies in sei minuti, Luna alla prova del gioco di Midway
Per misurare Luna su un lavoro reale le ho affidato lo stesso prompt usato oggi stesso con Claude Opus 5.5, cioè la creazione di uno sparatutto a scorrimento verticale ispirato a 1943: The Battle of Midway. Ho lavorato in OpenCode con OpenRouter come provider e il ragionamento impostato su medium, e in 6 minuti e 15 secondi Luna ha consegnato 1943: Pacific Skies, un livello completo e giocabile nel browser.
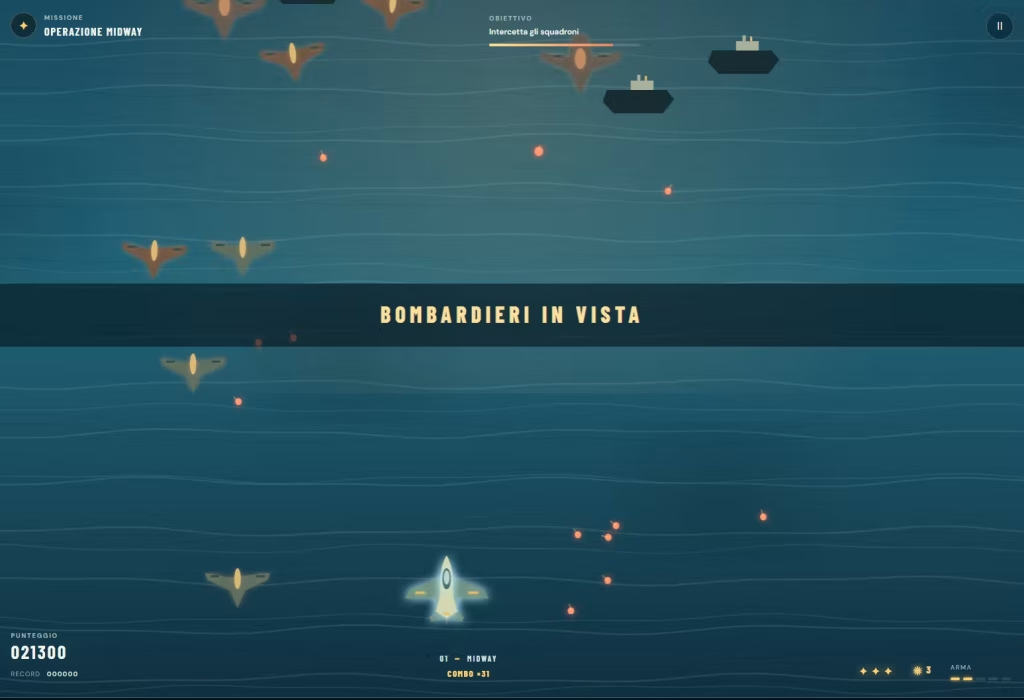
Il risultato è gradevole e funziona senza intoppi. La grafica vettoriale ha una palette elegante, con il mare animato su più strati e un’interfaccia ordinata, e il livello segue una progressione chiara: ondate di caccia, assi più agili, bombardieri e navi, fino alla corazzata finale, che intensifica il fuoco quando scende sotto metà dell’energia.
Non mancano cinque livelli di potenziamento dell’arma, le bombe che ripuliscono lo schermo, tre vite con un bonus ogni 25 abbattimenti, un moltiplicatore di combo, il salvataggio del record, la pausa, i comandi touch e il passaggio tra italiano e inglese.
Il confronto con Cieli di Midway, creato da Opus 5.5, mostra però una distanza netta. La fase che precede il boss dura meno di un minuto, la corazzata è un unico bersaglio senza parti da distruggere, l’audio si limita a pochi effetti sintetici.
Opus aveva invece costruito un boss intermedio, una portaerei da smontare pezzo per pezzo, meccaniche come il loop evasivo e un hangar con potenziamenti permanenti. Anche le dimensioni del progetto mostrano la differenza, con circa 55 KB fra HTML, CSS e JavaScript per Luna contro i 106 KB del gioco di Anthropic.
Per un modello che costa 0,10 dollari per milione di token in input il risultato resta eccellente, e in poco più di sei minuti offre una base solida su cui continuare a lavorare. Opus 5.5 garantisce una qualità decisamente superiore, ma impiega quasi il quadruplo del tempo e ha un listino quaranta volte più alto. Se ti serve un prototipo rapido da rifinire a mano, Luna è già sufficiente; se cerchi un risultato vicino al prodotto finito al primo tentativo, il modello di Anthropic resta un’altra categoria.
Un modello proprietario al prezzo di un open source cinese
GPT-6 Luna non è la proposta più capace della sua fascia, ma è quello che costa meno per portare a termine un compito, e questo cambia i conti per chi gestisce migliaia di richieste al giorno. Con sette centesimi per prova nell’indice di Artificial Analysis, due bug su tre corretti in DeepSWE e un tasso di allucinazioni in calo, OpenAI mette per la prima volta un modello chiuso sullo stesso terreno di DeepSeek, Qwen e MiMo, puntando su affidabilità e integrazione con ChatGPT, Codex e Copilot.
GPT-6 Sol, dal canto suo, si propone come alternativa economica ad Astra e ai modelli Anthropic per programmazione e processi aziendali, con prestazioni vicine a Fable 5 a circa un quinto del costo per attività.
Se costruisci agenti o flussi automatici ad alto volume, conviene provare Luna con un livello di ragionamento intermedio e salire solo dove serve, sfruttando la cache per documenti e istruzioni ricorrenti. Se invece hai bisogno di intervenire sul modello, DeepSeek V4.1 Flash e MiMo-V2.6 restano le alternative più interessanti. In entrambi i casi la corsa al ribasso dei prezzi gioca a favore di chi sviluppa.