

Gemini 4 Argon è il nuovo modello di frontiera di Google DeepMind e apre la generazione Gemini 4, dopo mesi dedicati quasi solo alla linea Flash, dalla 3.5 alla 3.8. Annunciato il 30 settembre per un gruppo ristretto di specialisti di sicurezza informatica del programma Fairwind, dal 13 ottobre è disponibile a livello globale nell’API, nell’app Gemini per gli abbonati AI Pro e Ultra e negli strumenti per sviluppatori. Argon è più grande dei precedenti modelli Pro. Logan Kilpatrick, che in Google lavora su AI Studio e sulla Gemini API, ha spiegato che ogni risposta richiede molta potenza di calcolo, quindi è impegnativo per l’azienda offrirlo a tutti e per questo sta preparando versioni più leggere per un pubblico più ampio.
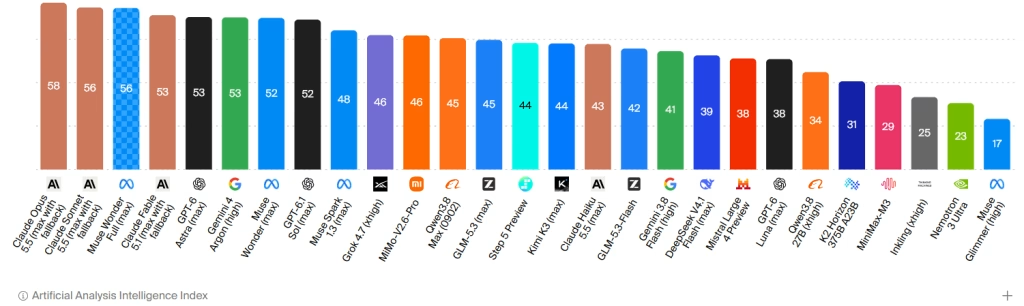
Il confronto con Gemini 3.1 Pro, l’ultimo modello di punta non Flash, rende bene l’idea del salto: il limite di output passa da circa 64.000 a 1 milione di token, mentre nell’indice di Artificial Analysis il punteggio sale da 30 a 53. La filosofia è quella dei lavori lunghi e strutturati, come creazione e migrazione di codice, analisi legali e finanziarie, difesa informatica e ricerca scientifica. È un modello ideale per sviluppatori, team aziendali e professionisti che affidano all’AI compiti da diverse ore, e i suoi punti di forza sono il contesto lungo, la comprensione dei video e un tasso di allucinazioni AI tra i più bassi della categoria.
Un MoE sparso che può scrivere fino a un milione di token
Dal punto di vista architetturale Argon è un transformer MoE sparso (mixture of experts), cioè un modello diviso in tanti blocchi specializzati di parametri, di cui per ogni token viene attivata solo una parte. In questo modo la capacità complessiva cresce senza che il costo di calcolo di ogni risposta aumenti nella stessa misura. Google precisa che Argon non deriva dalla rifinitura di una versione precedente ma da un addestramento nuovo, eseguito su TPU con i framework JAX e Pathways, mentre il numero di parametri e di esperti resta riservato.
Il modello è nativamente multimodale e accetta testo, immagini, audio, video e PDF, ma risponde solo in forma scritta. La finestra di contesto è di 1.048.576 token condivisi fra ingresso e uscita, e la novità più tangibile riguarda proprio la generazione: con la modalità long decode una singola risposta può raggiungere la stessa soglia, contro il limite predefinito di 65.536. Tradotto in pratica, il modello può scrivere una migrazione di codice o una traduzione molto estesa in un’unica passata, senza spezzare il lavoro in decine di richieste.
Il ragionamento si regola su tre livelli di thinking (low, medium e high) invece che con un budget numerico, e i token generati mentre il modello pensa vengono fatturati alla tariffa di uscita. Fra gli strumenti supportati ci sono la chiamata di funzioni esterne, le risposte in formato strutturato, l’esecuzione di codice, la ricerca nei file, l’ancoraggio dei risultati a Google Search e Maps, la lettura di URL e il computer use, cioè il controllo di un’interfaccia sul computer come farebbe una persona. Mancano invece la generazione di immagini e audio e la Live API, la cache è solo implicita e il limite di conoscenza è fissato a marzo 2026. Per far generare immagini al modello sarà sufficiente creare una skill che si appoggi a Nano Banana o a qualunque altro modello in grado di generare immagini.
Dove vince Argon
Il risultato su cui Google insiste di più è il 77,9% in DeepSWE v1.1, un test che non chiede di correggere un singolo bug ma di portare a termine attività di ingegneria del software lunghe e articolate su progetti reali, dove il modello deve orientarsi nel codice, modificare più file e verificare il proprio lavoro. In pratica Argon chiude quasi otto incarichi su dieci, contro il 74,2% di Claude Opus 5.5 e il 74,1% di GPT-6 Astra.
Più interessante, per chi lavora con archivi enormi, è GraphWalks nella fascia da 256.000 a 1 milione di token. Il test nasconde un grafo dentro un contesto lunghissimo e chiede di percorrerlo, verificando se il modello sfrutta l’intera finestra o si perde a metà strada. Argon ottiene l’84,2% contro il 71,8% di Astra e il 66,8% di Opus 5.5.
Il terzo dato arriva da una fonte indipendente. Nel test AA-Omniscience di Artificial Analysis, fatto di domande fattuali difficili, Argon inventa una risposta solo nel 15% dei casi in cui non conosce quella giusta, contro il 51% di Astra. Il rovescio della medaglia è che risponde correttamente alla metà dei quesiti, mentre il rivale arriva al 63%, perché preferisce astenersi se non sa rispondere.
Nel quadro complessivo è primo nel Vals Index con il 68,9%, mentre nella classifica generale della stessa società totalizza 53 punti, alla pari con GPT-6 Astra e Claude Fable 5.1 ma dietro Opus 5.5 (58) e Sonnet 5.5 (56). Resta poi una certa prolissità, con circa 62.000 token di output per attività contro i 27.000 di Astra.
- LVBench. 91,7% nella comprensione di video lunghi, contro l’87,5% del modello di OpenAI.
- Harvey Legal Agent Benchmark. 19,6% contro il 5,4% di Astra e il 3,8% di Opus 5.5.
- CWE-bench v1. 68% nella correzione di vulnerabilità, alla pari con il concorrente.
- Terminal-Bench 4.0. 57,4% contro il 66,4% di Opus 5.5.
- FrontierSWE v2. 55% contro il 65,5% di Astra.
- LMArena. Primo nella classifica testuale, non in quella WebDev.
Metà prezzo fino al 30 novembre
Argon è disponibile nel piano a pagamento della Gemini API e in Google AI Studio con l’identificativo gemini-4-argon, oltre che su Google Cloud e Gemini for business. Gli abbonati Google AI Pro (€21,99 al mese) lo trovano nell’app, in AI Mode, e in Antigravity, l’ambiente di sviluppo agentico di Google; il piano gratuito e il piano Google AI Plus restano esclusi da Argon e Antigravity.
Fino al 30 novembre vale il prezzo promozionale di 2 dollari per milione di token in ingresso e 10 in uscita, con la cache a 0,10 dollari per milione di token, e dal 1° dicembre le tariffe raddoppiano a 4 e 20. Esistono anche la fascia Flex, che dimezza ulteriormente la spesa, e quella Priority, che la aumenta dell’80% in cambio di tempi di risposta più rapidi.
Il confronto con i rivali cambia molto fra le due fasi. Oggi Argon costa quanto Claude Sonnet 5.5 e GPT-6.1 Sol, cioè un quinto di GPT-6 Astra e Fable 5.1, che costano rispettivamente 10 e 50 dollari. Da dicembre si allinea invece a Claude Opus 5.5 e a Muse Wonder di Meta, che partono anch’essi da 4 in ingresso. La verbosità pesa però sul conto finale, visto che secondo Artificial Analysis ogni attività dell’indice costa 1,99 dollari a prezzo promozionale e 3,98 a listino pieno, contro i 3,26 di Astra e gli 0,72 di Sol.
Fra i provider terzi il modello è arrivato quasi ovunque nello stesso giorno. OpenRouter lo instrada su AI Studio e Vertex con una velocità fra 46 e 60 token al secondo, Vercel AI Gateway lo propone come google/gemini-4-argon con lo stesso sconto e OpenCode lo ha integrato anche nel piano Go, che fino al 30 novembre offre 60 dollari di utilizzo a fronte di un abbonamento da 10. Il modello è inoltre disponibile in Cursor e in GitHub Copilot, nell’app, nella CLI e in VS Code.
Sette settimane di sconto per metterlo alla prova
Gemini 4 Argon riporta Google nella fascia più alta dopo una lunga stagione dedicata ai Flash, e si allinea ai prodotti di frontiera di OpenAI e Anthropic. Tutti gli altri sono momentaneamente dietro. Le prime prove che girano su X raccontano un modello molto efficiente, inoltre più rapido ed economico di Opus 5.5 nei progetti creativi.
Conviene sfruttare le tariffe dimezzate fino al 30 novembre per metterlo alla prova sui tuoi casi d’uso reali, confrontando non solo la qualità ma anche i token consumati e il costo per attività completata. A dicembre, con il prezzo raddoppiato, avrai dati tuoi per decidere se tenerlo come modello principale o riservarlo ai compiti in cui il milione di token in uscita fa la differenza.