



Google ha presentato due nuovi modelli pensati per portare la conversazione vocale con l’intelligenza artificiale a un livello di naturalezza superiore: Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking. Entrambi sono eredi diretti di Flash Live 3.1, lanciato lo scorso marzo, e portano con sé un salto sia in termini di intelligenza sia di capacità di ragionamento parallelo.
La differenza tra i due modelli è concettuale prima ancora che tecnica. Gemini 3.8 Live è pensato per la scala e l’efficienza dei costi, offrendo un dialogo fluido unito al riconoscimento visivo in tempo quasi reale. Gemini 3.8 Live Extended Thinking, invece, è calibrato per i compiti ad alta complessità, dove il ragionamento multi-step diventa determinante.
Questa scelta di differenziazione risponde a un’esigenza precisa del mercato, dove non tutte le applicazioni vocali richiedono lo stesso livello di potenza computazionale. Un assistente che gestisce prenotazioni o risponde a domande semplici non ha bisogno delle stesse risorse di un agente che deve orchestrare operazioni bancarie complesse o analizzare documenti articolati. Per questo motivo, l’arrivo di due varianti distinte segna un cambio nell’approccio di Google alla voce come interfaccia primaria.
Gemini 3.8 Live ed Extended Thinking: come funziona il ragionamento in tempo reale
Il punto di forza di questi modelli riguarda la capacità di eseguire operazioni in background senza interrompere la conversazione. Quando serve una ricerca o una chiamata a uno strumento esterno, il modello continua a dialogare mentre l’attività viene completata dietro le quinte. Si evitano così quei silenzi imbarazzanti tipici degli assistenti vocali di prima generazione.
Gemini 3.8 Live Extended Thinking spinge questo meccanismo ancora oltre. Il modello ragiona e parla simultaneamente, utilizzando segnali verbali naturali come “Fammi controllare…” per confermare di aver recepito la richiesta, per poi narrare in tempo reale i progressi di un’attività articolata su più passaggi. Inoltre, è presente la gestione multilingue, con il riconoscimento automatico e il passaggio tra 97 lingue diverse nel corso della stessa conversazione, senza bisogno di riconfigurare nulla.
Gemini 3.8 Live, invece, aggiunge anche l’elaborazione degli input visivi in tempo quasi reale, arricchendo il contesto della conversazione con informazioni provenienti dall’ambiente circostante.
I numeri dei benchmark e l’integrazione nell’ecosistema
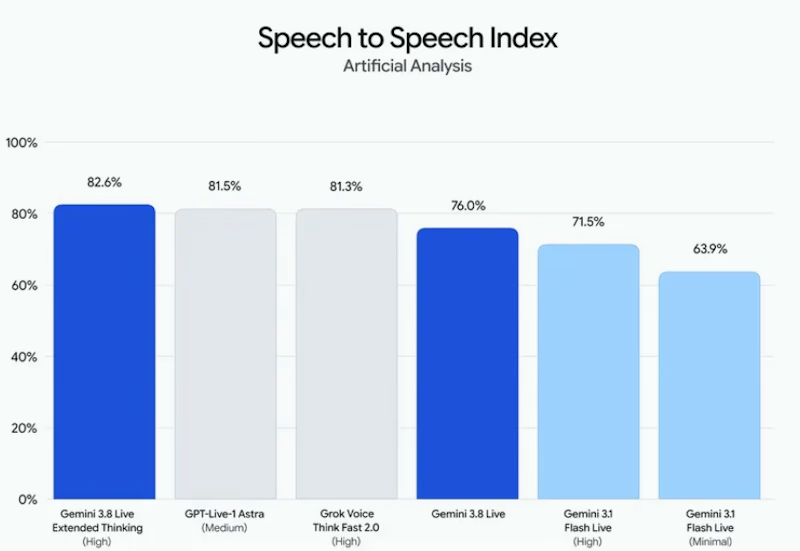
Sul fronte delle prestazioni, Gemini 3.8 Live Extended Thinking rivendica il primo posto assoluto nello Speech to Speech Quality Index di Artificial Analysis, con un punteggio di 82.6.
Guida inoltre la classifica nel completamento di compiti agentici, con il 68.6% su τ-Voice e il 35.1% sul benchmark bancario τ-Voice-banking di Sierra. Sul fronte del ragionamento puro, il modello segna un notevole 97.7% su Big Bench Audio, mantenendo comunque un posizionamento di prezzo competitivo rispetto ad altri modelli di punta.
Gemini 3.8 Live, pur essendo la variante più leggera, non sfigura affatto. Si è guadagnato il secondo posto nella Speech Agent Arena, confermandosi una scelta solida per chi cerca efficienza senza rinunciare troppo alla qualità.
Sul piano dell’adozione, i due modelli sono già integrati in diversi prodotti Google, tra cui Gmail Live per la ricerca conversazionale, Docs Live per la generazione e la modifica di bozze, Keep Live per la creazione rapida di note, oltre a Gemini Live e Search Live.
Per chi sviluppa, l’accesso passa attraverso l’API Gemini e Google AI Studio, mentre per le aziende è prevista un’anteprima privata su Gemini Enterprise.
Un percorso da monitorare con attenzione
Gemini 3.8 Live e la sua variante Extended Thinking si inseriscono nel percorso di Google verso la voce come interfaccia principale per interagire con l’IA.
I numeri dei benchmark indicano un progresso concreto nella capacità di gestire compiti complessi senza sacrificare la naturalezza del dialogo. Tuttavia, i punteggi comunicati provengono da benchmark selezionati dall’azienda stessa. Per una valutazione reale bisogna aspettare i primi riscontri pratici da parte di sviluppatori e utilizzatori finali.
Inoltre, la distribuzione differenziata tra le due varianti, con funzionalità che arrivano prima ad alcuni segmenti rispetto ad altri, potrebbe generare qualche incertezza su cosa sia effettivamente disponibile e dove.
Resta comunque importante l’attenzione dedicata alla trasparenza, con il watermarking SynthID applicato a tutto l’audio generato per contrastare la disinformazione.