

Anthropic ha rilasciato il 28 settembre Claude Sonnet 5.5, il secondo modello della famiglia Claude 5.5 dopo Opus 5.5, uscito soltanto sei giorni prima. Nella gamma occupa la fascia intermedia, quella dedicata al lavoro di ogni giorno, e prende il posto di Sonnet 5 mantenendo lo stesso listino, cioè 2 dollari per milione di token in input e 10 in output. L’approccio del produttore punta sull’efficienza più che sul prezzo, perché la tariffa per token resta identica mentre calano i consumi, con un costo per attività ridotto fino al 30% e una generazione del testo oltre il 30% più rapida.
Il confronto con il predecessore Sonnet 5 è netto. Su Terminal-Bench 4.0, la prova che misura il lavoro autonomo da riga di comando, Sonnet 5.5 passa dal 10,3% al 70,6%, mentre nelle attività d’ufficio arriva a due punti Elo da Opus 5.5. Si rivolge a chi sviluppa software, a chi prepara documenti, presentazioni e fogli di calcolo e a chi costruisce agenti che devono rispondere in fretta senza far salire il conto dei token. Per i progetti lunghi, invece, la stessa Anthropic continua a indicare Opus come scelta migliore.
Livelli di effort, ragionamento vincolato all’account e cambi per chi usa l’API
Il pensiero adattivo di Sonnet 5.5 si regola con il parametro effort, che offre cinque livelli (low, medium, high, xhigh e max) per decidere quanto il modello rifletta prima di rispondere. Nelle app Claude e in Claude Code il valore predefinito è medium, mentre sull’API parte da high. Anthropic consiglia di iniziare con Opus per i grandi progetti e con Sonnet quando serve equilibrio fra qualità, velocità e costo. La finestra di contesto resta di 1 milione di token e le risposte possono arrivare a 128.000 token.
Il ragionamento non si può più disattivare con thinking: disabled, che restituisce un errore, e chi lo faceva con Sonnet 5 deve passare alla modalità between_tools, disponibile ai livelli low, medium e high.
Sonnet 5.5 è anche il primo Sonnet con le protezioni informatiche dei modelli più potenti. Le richieste ad alto rischio passano in modo visibile a Sonnet 5, mentre lo sviluppo software ordinario non cambia, e Artificial Analysis ha osservato questo passaggio in circa lo 0,1% delle prove. Per la sicurezza nel campo della biologia valgono le stesse regole di Sonnet 5.
Terminal-Bench, GDPval e CursorBench mostrano un Sonnet vicino a Opus
La prova che descrive con più chiarezza la distanza da Sonnet 5 è Terminal-Bench 4.0, dove il modello opera in una shell reale per compilare, configurare e correggere senza aiuto umano. Sonnet 5.5 ottiene il 70,6%, cioè riesce in circa sette compiti su dieci, contro il 66,4% di Opus 5.5. Artificial Analysis, con un proprio ambiente di prova, misura il 64% contro il 60% di Opus 5.5 e di GPT-6 Astra.
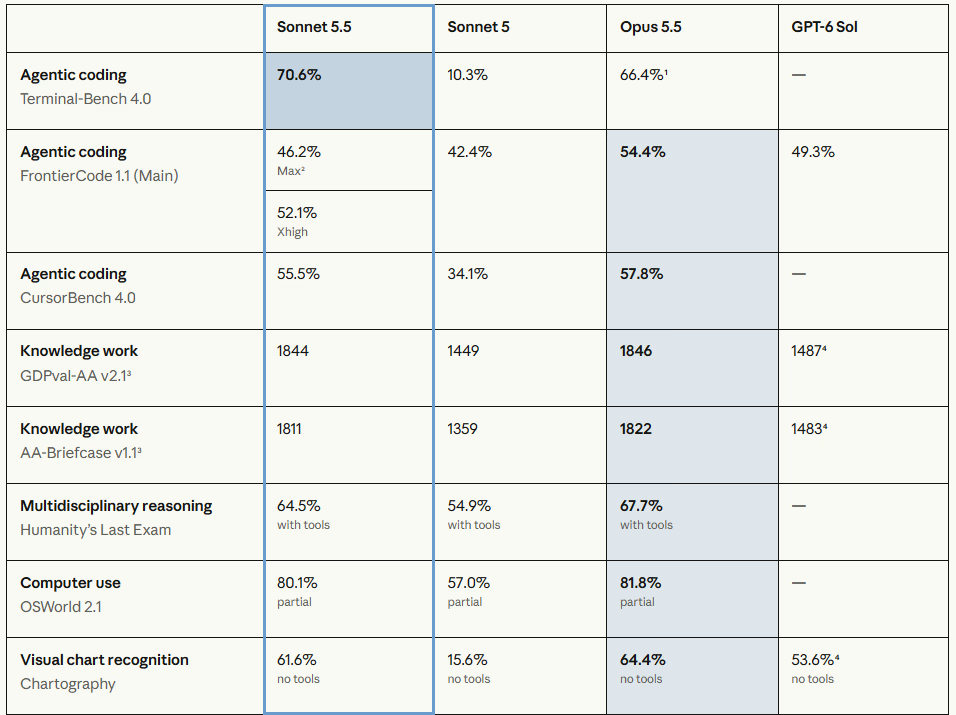
Nel lavoro d’ufficio conta GDPval-AA v2.1, che confronta gli elaborati dei modelli su professioni di ogni tipo e li ordina con un punteggio Elo, come negli scacchi. Sonnet 5.5 totalizza 1844 punti contro i 1846 di Opus 5.5 e i 1449 di Sonnet 5, mentre su AA-Briefcase, dedicato ai progetti di più ore, arriva a 1811 contro 1822. Su CursorBench 4.0, che usa compiti reali su più file, ottiene il 55,5% contro il 57,8% di Opus e il 34,1% di Sonnet 5.
Gli altri risultati seguono la stessa scia, con l’80,1% su OSWorld 2.1 per l’uso del computer contro l’81,8% di Opus e il 64,5% su Humanity’s Last Exam con strumenti contro il 67,7%. Su FrontierCode 1.1 si ferma al 52,1% con xhigh, contro il 54,4% di Opus, e scende al 46,2% con max, un calo che l’analisi di Vellum attribuisce a un eccesso di sotto-agenti e a timeout.
La lettura di Artificial Analysis conferma la vicinanza, con 56 punti nell’Intelligence Index contro i 58 di Opus 5.5 e i 38 di Sonnet 5. Conviene però guardare i consumi, perché al livello max il modello usa circa 193.000 token di output per prova, il valore più alto misurato finora, e spende 7,60 dollari per attività, quasi il 50% più di Sonnet 5.
Anche la conoscenza fattuale resta indietro, con il 54% di risposte corrette contro il 66% di Opus, sebbene il tasso di allucinazioni sia più basso (47% contro 59%).
Listino fermo a 2 e 10 dollari e una sfida diretta con GPT-6 Sol
Le tariffe API restano a 2 dollari per milione di token in input e 10 in output, con letture della cache a 0,20 dollari e scritture a 2,50. Sono le stesse di Sonnet 5, che dal 10 agosto ha reso permanente la tariffa introduttiva, quindi il risparmio dichiarato da Anthropic nasce dai minori consumi e non da uno sconto. Su diversi benchmark i livelli low e medium superano il miglior risultato di Sonnet 5 con un costo per attività di circa un decimo.
| Modello | Input ($/M token) | Output ($/M token) | Lettura cache ($/M token) |
|---|---|---|---|
| Claude Sonnet 5.5 | 2 | 10 | 0,20 |
| Claude Opus 5.5 | 4 | 20 | 0,20 |
| GPT-6 Sol | 2 | 10 | 0,20 |
| GPT-6 Luna | 0,10 | 0,50 | 0,01 |
Il confronto più interessante riguarda GPT-6 Sol di OpenAI, che ha lo stesso listino e, nelle misure di Artificial Analysis al livello max, costa per attività 1,06 dollari contro i 7,60 di Sonnet 5.5.
Il modello è disponibile nelle app Claude, in Claude Code e sull’API con il nome claude-sonnet-5-5, oltre che su Amazon Bedrock, Google Cloud e Microsoft Foundry, con l’opzione zero data retention, cioè senza conservazione dei dati da parte del fornitore. Tra i provider di terze parti è già presente su OpenRouter allo stesso prezzo, su Vercel AI Gateway e su GitHub Copilot per i piani Pro, Pro+, Max, Business ed Enterprise, in rilascio graduale. Haiku 5.5 il modello più piccolo della famiglia Claude 5.5 dovrebbe arrivare nelle prossime settimane.
Medium e high, i due livelli con cui conviene iniziare a usare Sonnet 5.5
Claude Sonnet 5.5 non sostituisce Opus 5.5, ma ne avvicina i risultati su programmazione da terminale, lavoro d’ufficio e uso del computer a metà del prezzo per token. Il vantaggio è più netto rispetto a Sonnet 5, che supera su tutti i test pubblicati da Anthropic e con un costo per attività inferiore finché si resta ai livelli intermedi. È una scelta sensata per chi sviluppa con Claude Code, per chi prepara presentazioni e fogli di calcolo e per chi gestisce agenti di assistenza, dove tempi e costi contano quanto la qualità.
Se devi partire da un punto, prova Sonnet medium e sali a high solo quando la qualità non basta. Opus tienilo invece per i progetti a cui tieni di più.