


Anthropic ha rilasciato il 22 settembre Claude Opus 5.5; il modello si colloca sotto la fascia più alta, dove risiedono Claude Fable 5.1 e Mythos 5.1, eppure secondo il produttore offre prestazioni paragonabili a Fable 5.1 nella maggior parte delle attività con un costo di esercizio inferiore del 40% rispetto al precedente Opus 5.
L’approccio della casa di San Francisco punta sull’efficienza più che sulla forza bruta, tanto che Opus 5.5 richiede meno potenza di calcolo per funzionare sui server e il listino scende di conseguenza.
Rispetto a Opus 5, il nuovo modello genera testo oltre il 30% più velocemente, guida le classifiche di programmazione agentica, di uso del computer e di lavoro d’ufficio complesso, e corregge una delle critiche più frequenti al predecessore, cioè uno stile di scrittura prolisso e poco lineare.
Si tratta inoltre del primo modello rilasciato dopo che Anthropic ha invitato apertamente a rallentare il ritmo con cui avanza la frontiera dell’AI e, come i precedenti, è passato dalle valutazioni esterne di organizzazioni come METR. Si rivolge soprattutto a sviluppatori, team che costruiscono agenti autonomi e professionisti che affidano all’AI analisi, documenti e migrazioni di codice di grandi dimensioni.
Ragionamento sempre attivo e livelli di effort
Sul piano tecnico la novità più evidente riguarda il modo in cui il modello elabora le risposte. In Opus 5.5 il pensiero adattivo è sempre attivo e non si può più spegnere, né è possibile fissare un budget di token dedicato al ragionamento. Al suo posto c’è il parametro effort (letteralmente sforzo), con cinque livelli (low, medium, high, xhigh e max) che stabiliscono quanto a lungo il modello riflette prima di rispondere.
Il valore predefinito scende da high a medium, e proprio su questa impostazione si basa la stima del risparmio, perché secondo Anthropic Opus 5.5 al livello intermedio eguaglia o supera Opus 5 configurato su quello alto nelle attività di programmazione e di lavoro intellettuale.
La finestra di contesto resta di 1 milione di token, ogni risposta può arrivare a 128.000 (300.000 in beta con l’elaborazione in batch) e le conoscenze si fermano a giugno 2026.
Cambia invece la gestione dei blocchi di ragionamento, ora legati al modello che li ha prodotti e alla parte iniziale della conversazione. Se il prompt di sistema o gli strumenti cambiano a metà strada, l’API restituisce un errore; di conseguenza conviene gestire i dialoghi in modalità append-only, cioè aggiungendo messaggi senza modificare quelli precedenti.
Scompare anche il tool use forzato, che obbligava il modello a chiamare uno strumento preciso, sostituito dagli structured outputs, cioè risposte vincolate a uno schema, o dalla modalità strict, che garantisce parametri sempre validi, mentre il controllo del PC passa al nuovo computer_toolset_20260801.
Tra le funzioni in beta figurano la compattazione su richiesta del contesto, la possibilità di aggiungere strumenti a una conversazione avviata senza perdere la cache e la modalità veloce (fast mode), che promette fino a 2,5 volte la velocità ma solo tramite API diretta. Migliora anche la visione, con una lettura più precisa di grafici e screenshot.
Infine, per la protezione dagli abusi, Opus 5.5 adotta gli stessi classificatori di Fable 5.1 per cybersecurity e biologia: la maggior parte delle richieste di sicurezza informatica viene dirottata su Opus 4.8.
Terminal-Bench e GDPval, dove si misura il distacco da Opus 5
La prova che descrive con più chiarezza la distanza da Opus 5 è Terminal-Bench 4.0, che mette il modello davanti alla riga di comando e gli chiede di completare lavori reali, come compilare progetti, configurare servizi o risolvere errori, senza aiuto umano. Opus 5.5 raggiunge il 66,4%, cioè riesce in circa due compiti su tre, contro il 52,3% di Opus 5, il 55,8% di Fable 5.1 e il 57,9% di GPT-6 Astra di OpenAI.
Il secondo riferimento utile è GDPval-AA v2.1, che confronta i modelli su attività professionali di decine di mestieri diversi, dal report finanziario alla presentazione aziendale, e assegna un punteggio Elo come nella valutazione degli scacchi. Opus 5.5 ottiene 1846 punti, 111 in più di Fable 5.1 e 138 in più di Opus 5: in un confronto diretto con Fable 5.1 il suo elaborato verrebbe preferito circa due volte su tre.
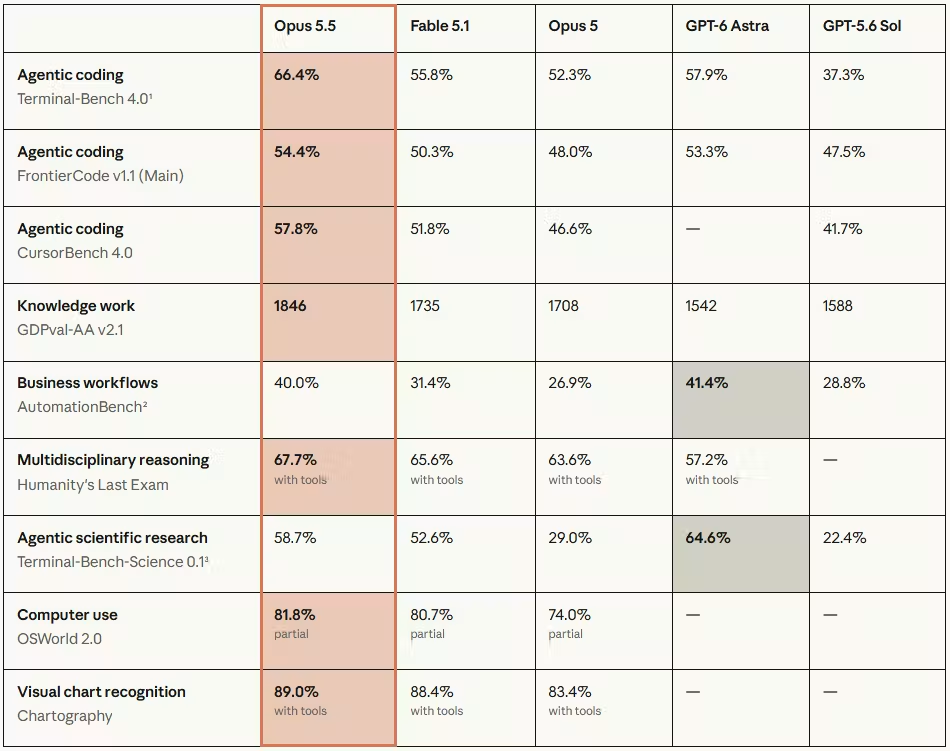
Il terzo è Humanity’s Last Exam, una raccolta di domande di livello accademico avanzato su matematica, scienze e discipline umanistiche, pensata per non essere risolvibile con semplici ricerche. Con l’uso di strumenti Opus 5.5 arriva al 67,7%, davanti a Fable 5.1 (65,6%) e GPT-6 Astra (57,2%).
Completano il quadro il 54,4% su FrontierCode v1.1, il 57,8% su CursorBench 4.0, l’81,8% su OSWorld 2.0 per l’uso del computer e l’89% su Chartography per la lettura dei grafici. Non manca qualche ambito in cui GPT-6 Astra resta davanti, come AutomationBench (41,4% a 40%) e Terminal-Bench-Science (64,6% a 58,7%), anche se su quest’ultimo Opus 5.5 raddoppia il 29% di Opus 5.
Artificial Analysis assegna a Opus 5.5 in modalità max un punteggio di 58 nel suo Intelligence Index, il più alto misurato finora, contro 53 di Fable 5.1 e 51 di Opus 5. Con la propria configurazione di test ottiene il 59,6% su Terminal-Bench 4.0, alla pari con GPT-6 Astra, e il 61,4% su Humanity’s Last Exam, valori diversi da quelli di Anthropic perché cambiano strumenti e ambiente di esecuzione.
Un dato merita attenzione se usi il livello max, cioè i circa 119.000 token di output per attività contro i 73.000 di Opus 5 e i 27.000 di GPT-6 Astra. Al massimo sforzo, quindi, il costo per compito si riallinea a quello del predecessore.
Opus 5.5: listino ridotto e una cache che costa quasi nulla
Le tariffe API scendono a 4 dollari per milione di token in input e 20 dollari in output, contro 5 e 25 di Opus 5. Il taglio unitario è quindi del 20%, mentre il risparmio del 40% indicato da Anthropic nasce dalla combinazione tra prezzo più basso ed effort predefinito più leggero. Ancora più forte lo sconto sulla cache dei prompt: le letture costano 0,20 dollari per milione, il 95% in meno dell’input standard, mentre la scrittura richiede 5 dollari per la memorizzazione da cinque minuti e 8 per quella da un’ora. La Batch API dimezza le tariffe a 2 e 10, mentre la modalità veloce le raddoppia a 8 e 40.
Il modello è disponibile nelle app Claude per gli abbonamenti Pro, Max, Team ed Enterprise, in Claude Code, sull’API con l’identificativo claude-opus-5-5 e su Amazon Bedrock, Google Cloud e Microsoft Foundry.
Tra i provider di terze parti è già presente su OpenRouter, su Vercel AI Gateway, che offre anche una variante veloce, su OpenCode Zen allo stesso prezzo di listino e su GitHub Copilot per i piani Pro+, Max, Business ed Enterprise, in rilascio graduale. Per gli abbonati, inoltre, Anthropic ha alzato del 20% i limiti d’uso sulle cinque ore e ha concesso un azzeramento dei contatori da sfruttare a piacere entro il 22 ottobre.
Sempre sul fronte dei prezzi Opus 5.5 costa il 60% in meno di Fable 5.1 e di GPT-6 Astra, entrambi a 10 e 50 dollari, ma OpenAI ha risposto nello stesso giorno con GPT-6 Sol a 2 e 10 e con GPT-6 Luna a 0,10 e 0,50, pensati per carichi di lavoro ripetitivi e voluminosi. Se ti serve il massimo sui compiti agentici lunghi, Opus 5.5 è oggi tra le scelte con il miglior rapporto tra qualità e costo per attività, mentre per estrazione e sintesi in grandi quantità i modelli economici di OpenAI restano più convenienti.
Cieli di Midway, un primo livello completo in 23 minuti
Per capire come si comporta Opus 5.5 fuori dai benchmark l’ho messo alla prova con un compito che unisce programmazione, grafica e game design, cioè ricreare in chiave moderna lo spirito di 1943: The Battle of Midway, lo sparatutto a scorrimento verticale di Capcom. Il modello ha lavorato con effort medium, il valore predefinito, e in 23 minuti ha consegnato Cieli di Midway, un primo livello giocabile nel browser su computer, tablet e smartphone, consumando appena il 20% della sessione di cinque ore di un abbonamento Pro.
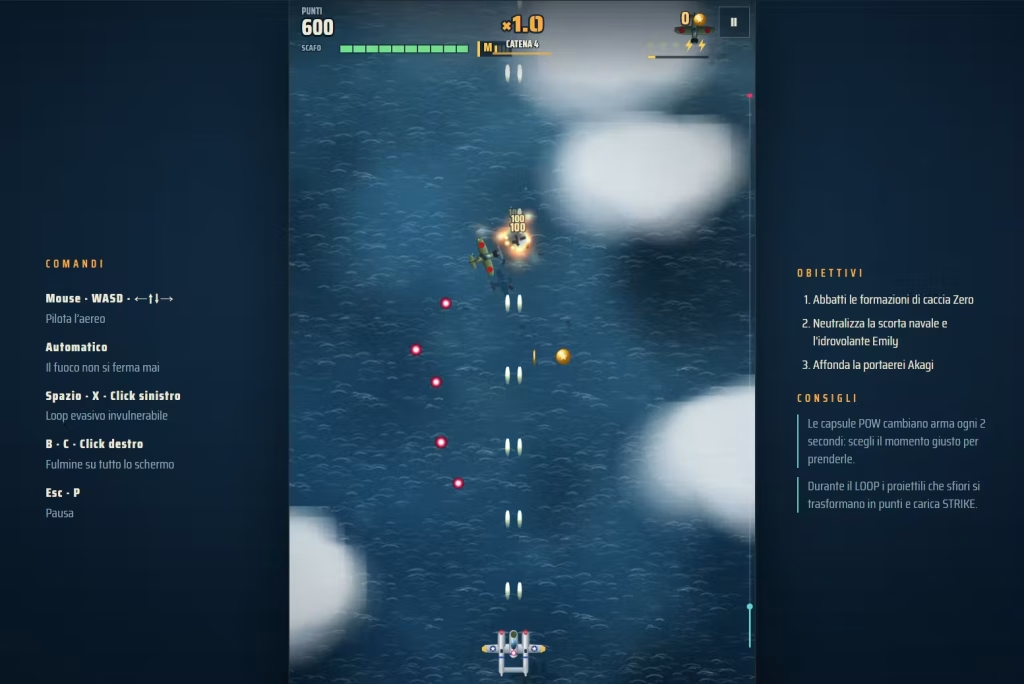
Il risultato va oltre la semplice demo. Si pilota un P-38 Lightning decollato dalla USS Yorktown e si affrontano ondate di caccia Zero, bombardieri e navi di scorta, poi un idrovolante Emily come boss intermedio e infine la portaerei Akagi.
Il sistema di gioco ha una sua profondità. Le capsule POW cambiano arma ogni due secondi e obbligano a scegliere l’istante giusto per raccoglierle, il loop evasivo rende invulnerabili e trasforma i proiettili sfiorati in carica per lo Strike, un attacco che investe tutto lo schermo, mentre gli abbattimenti in rapida successione fanno salire il moltiplicatore fino a ×5.
Colpisce anche la cura per gli aspetti meno visibili. Le medaglie raccolte si spendono in un hangar con cinque potenziamenti permanenti, i suggerimenti compaiono nel momento in cui servono, l’interfaccia passa dall’italiano all’inglese traducendo anche tutorial e messaggi, e i comandi touch evitano che il dito copra l’aereo. Grafica e audio sono generati interamente via codice, senza file esterni né Blender, e il gioco abbassa da solo la qualità se il frame rate cala sui dispositivi più lenti.
Non si tratta di un titolo tripla A, com’era prevedibile, ma di un prototipo curato e divertente che a uno sviluppatore richiederebbe con ogni probabilità diversi giorni fra codice, grafica e sonoro. Il livello intermedio Opus 5.5 ha tenuto conto di tutte le priorità indicate nel prompt, dalla progressione economica alle prestazioni su mobile.
Il testo completo della richiesta è riportato qui sotto. Il gioco consegnato, Cieli di Midway, non ha subito correzioni o miglioramenti di alcun genere.
Crea un gioco sul genere 1943: The Battle of Midway in forma moderna e accattivante, qualità gioco AAA.
Gioco completo e realmente giocabile usando browser sia su desktop che su tablet che su smartphone.
L'obiettivo principale è creare un gioco di qualità tripla A divertente, coinvolgente, immediatamente comprensibile e con una buona profondità di gameplay.
Se hai bisogno sul computer è installato Blender e puoi creare un mpc se necessario.

Durante lo sviluppo verifica sempre:

* il gioco è divertente ?
* c'è sempre un'azione interessante ?
* le ricompense motivano a continuare ?
* la difficoltà cresce in modo sensato ?

Quando individui un problema, modifica il gameplay prima di aggiungere nuove funzionalità.

## Priorità di sviluppo

1. Divertente, avvincente e ad alta giocabilità.
2. gameplay solido, immediatamente comprensibile e capace di mantenere l'interesse.
3. Controlli semplici e responsivi. Giocabile con tastiera e/o mouse e touch.
5. Economia e progressione coerenti: risorse, ricompense e potenziamenti devono alimentare il gameplay.
4. Bilanciamento: difficoltà, ricompense, nemici e poteri del giocatore devono produrre una curva  soddisfacente.
5. Stile artistico e grafico moderno fluido e appagante.
6. Performance: 60 fps desktop, 30+ fps tablet e smartphone, massimo 80 nemici simultanei.
7. Responsive: il gioco deve adattarsi a smartphone, tablet e desktop.
8. Lingue IT (default) ed EN**, con toggle nell'interfaccia. Traduci anche tutorial, messaggi di gioco, obiettivi e testi dell'interfaccia.

se tutto chiaro procedi, per ora crea solo il primo livello del gioco.Prestazioni da Fable 5.1 a meno della metà del prezzo
Claude Opus 5.5 porta nella fascia Opus risultati che fino a ieri richiedevano Fable 5.1, con un listino pari al 40% di quello del modello più grande e una generazione del testo più rapida. Gli esiti più solidi arrivano dai compiti agentici, quelli in cui il modello opera da solo per ore tra terminale, file e strumenti, e dal lavoro d’ufficio complesso, dove sia le prove del produttore sia le misurazioni di Artificial Analysis lo collocano in testa. Anche lo stile di scrittura, più diretto e con le informazioni importanti in apertura, risponde a una critica diffusa verso Opus 5.
Se usi Claude Code o costruisci agenti, conviene partire dal livello medium e salire a high o xhigh solo sui compiti che lo giustificano, perché l’impostazione max consuma molti più token e annulla buona parte del risparmio.
Per chi ha già un abbonamento Pro o Max il passaggio è immediato e, grazie ai limiti ampliati, anche più generoso. Per ora Opus 5.5 è la proposta Anthropic più sensata per la maggior parte dei progetti professionali, dalla programmazione alla produzione di documenti.